 北京昌平
 北京顺义
 上海
 广州
 深圳
 武汉
 郑州
 西安
 长沙
 济南
 南京
 杭州
 成都


- 百川智能全科医疗大模型、豆包医疗智能体

大模型应用全面落地
AI重塑行业新未来
全国班级学生
平均薪资
一线就业学生
平均薪资
全国应届学生
平均薪资
数据来源:脉脉、人社部、职友集及CNNIC公开数据
从应用开发到算法全覆盖
你学的就是企业需要的
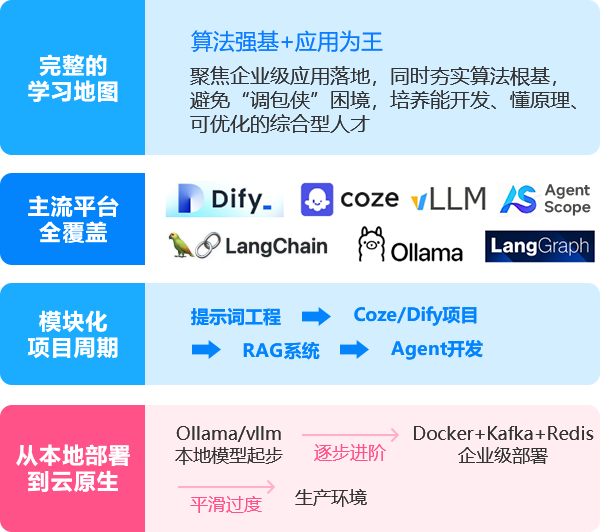
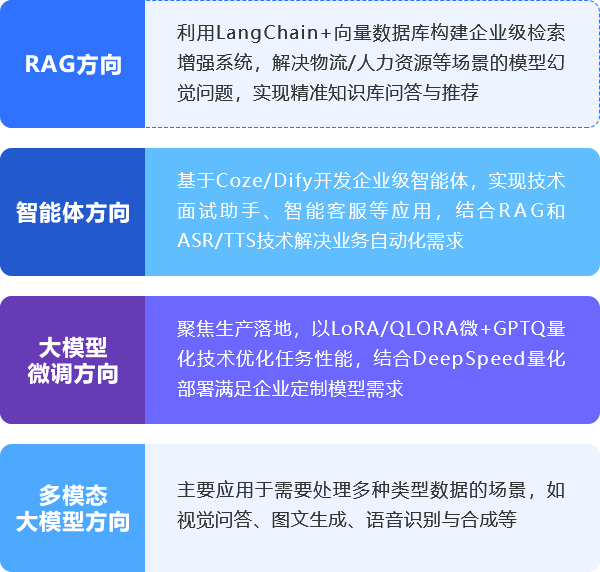
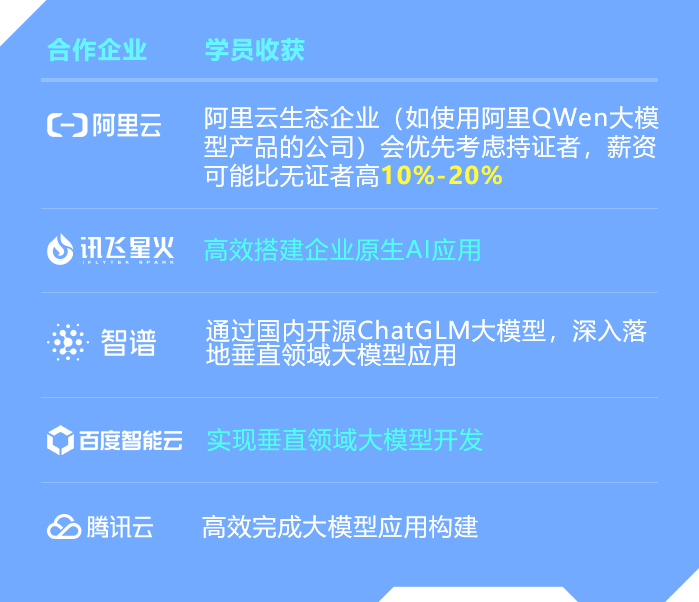
选择黑马程序员
0基础速通大模型开发
没有工作经验,期待学习有前景的AI大模型技术
零基础,对人工智能/大模型感兴趣,致力于通过人工智能/大模型解决实际业务问题
具备Java、前端、大数据、运维等开发经验,面临职场瓶颈期,期待自我提升
数据来源:职友集/ 智联招聘等行业调研数据
Vibe Coding × Harness强强融合
课程与市场零时差
自研企业级
OpenClaw框架
构建Agentic
Workflow
Agent Harness工程
开发范式与
行业趋势对齐
课程教授如何利用Harness理念,让大模型具备“手”和“眼”,自主调用搜案、数据库、API等外部工具,构建真正的AgenticWorkflow(智能体工作流)
学员将掌握Prompt Engineering进阶版(Context Management)、AI代码审查、以及多智能体协作管理,成为AI时代的技术指挥官
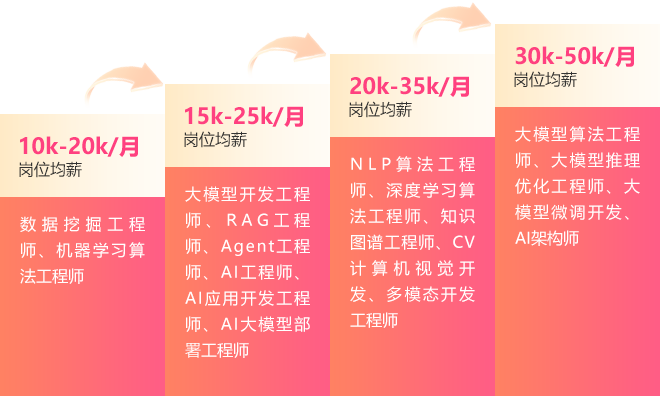
从初级开发到AI大模型专家
100天挑战年薪30w+
智能体开发(Coze)、Python基础语法、VibeCoding理念与准备、医疗问诊系统项目前后端开发、医疗问诊系统项目上线部署
能力画像:掌握人工智能Python语言,掌握模型私有化方法,能够通过Python调用私有化部署API实现通用聊天机器人搭建
胜任岗位:初级AI开发工程师
参考薪资:10-12k
Python编程进阶、数据处理与统计分析、Numpy矩阵运算库、Pandas数据处理、大模型入门、Prompt Engineering、智能体开发(Coze项目)、智能体开发(Dify项目)
能力画像:掌握利用Python进行数据处理及数据统计分析,为数据建模奠定技术基础。同时通过Coze和Dify构建工作流和智能体开发,快速构建智能体
胜任岗位:数据分析师、Coze开发工程师、Dify开发工程师
参考薪资:10-14k
NLP基础任务、机器学习开发流程、深度学习、Pytorch框架、机器学习、NLP技术基础、NLP技术进阶、深度学习正则化与算法优化
能力画像:掌握机器学习、深度学习与NLP核心算法,能够解决模型构建和训练关键问题
胜任岗位:机器学习工程师、深度学习工程师、算法工程师
参考薪资:15-18k
LangChain框架、ChatGLM模型集成、RAG搭建方案、EduRAG项目、SmartRecruitRAG项目
能力画像:通过LangChain框架完成大模型RAG功能定制化开发
胜任岗位:RAG开发工程师、智能体全栈开发工程师
参考薪资:18-20k
LangGraph框架、图计算模型、MCP 工具、Multi-Agent 协作、企业级 AI Agent 落地方案、A2A (Agent-to-Agent)、Agent WorkFlow、Agent Loop、多智能体协作、Agent Harness
能力画像:通过LangGraph框架完成Agent Workflow及Agent
Loop、Agent Harness等定制化开发
胜任岗位:Agent开发工程师、智能体全栈开发工程师
参考薪资:20-24k
Transformer原理、迁移学习、大模型微调、模型调优、大模型主流运行机制、大模型微调开发、大模型蒸馏、大模型核心专题、OpenClaw、DeepSeek、DeepSpeed、基于RHLF的强化学习、Hermes Agent专题、模型推理优化
能力画像:设计、实现与优化垂直领域大模型
胜任岗位:大模型开发工程师、算法工程师、大模型算法专家、大模型训练/推理开发工程师
参考薪资:20-35k
CV图像分析、多模态大模型、图像生成、小程序搭建、文图匹配、扩散模型噪声去除、全模态大模型、深度学习正则化与算法优化
能力画像:通过图像和视频分析、物体识别等技术,实现机器视觉
胜任岗位:CV算法工程师、目标检测工程师、图像处理工程师、深度学习工程师
参考薪资:15-20k
数据结构、常见算法、机器学习/深度学习、NLP/CV专题、大模型专题 …
课程大纲及学习安排
【详细版】
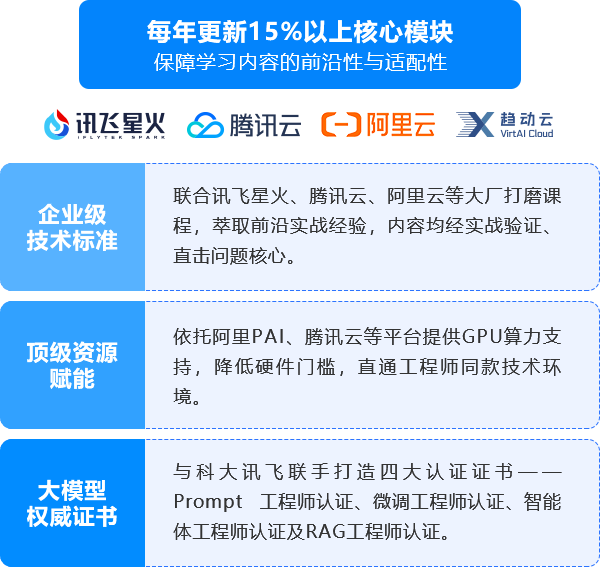
联合头部大厂共建课程
聚焦大模型核心技术

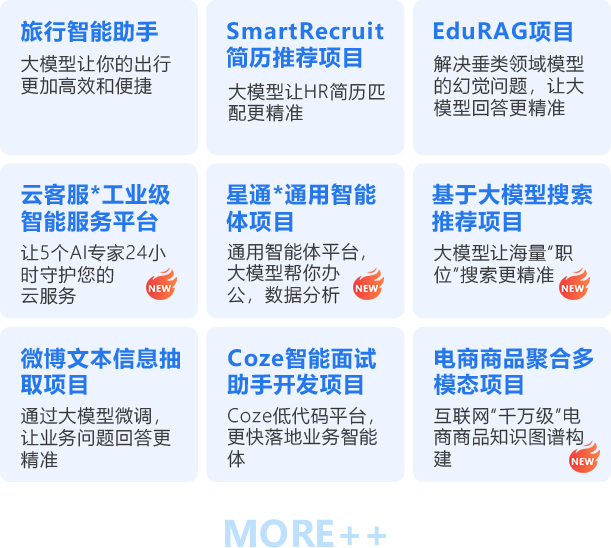
企业级多场景项目实战
练就解决复杂问题的真能力
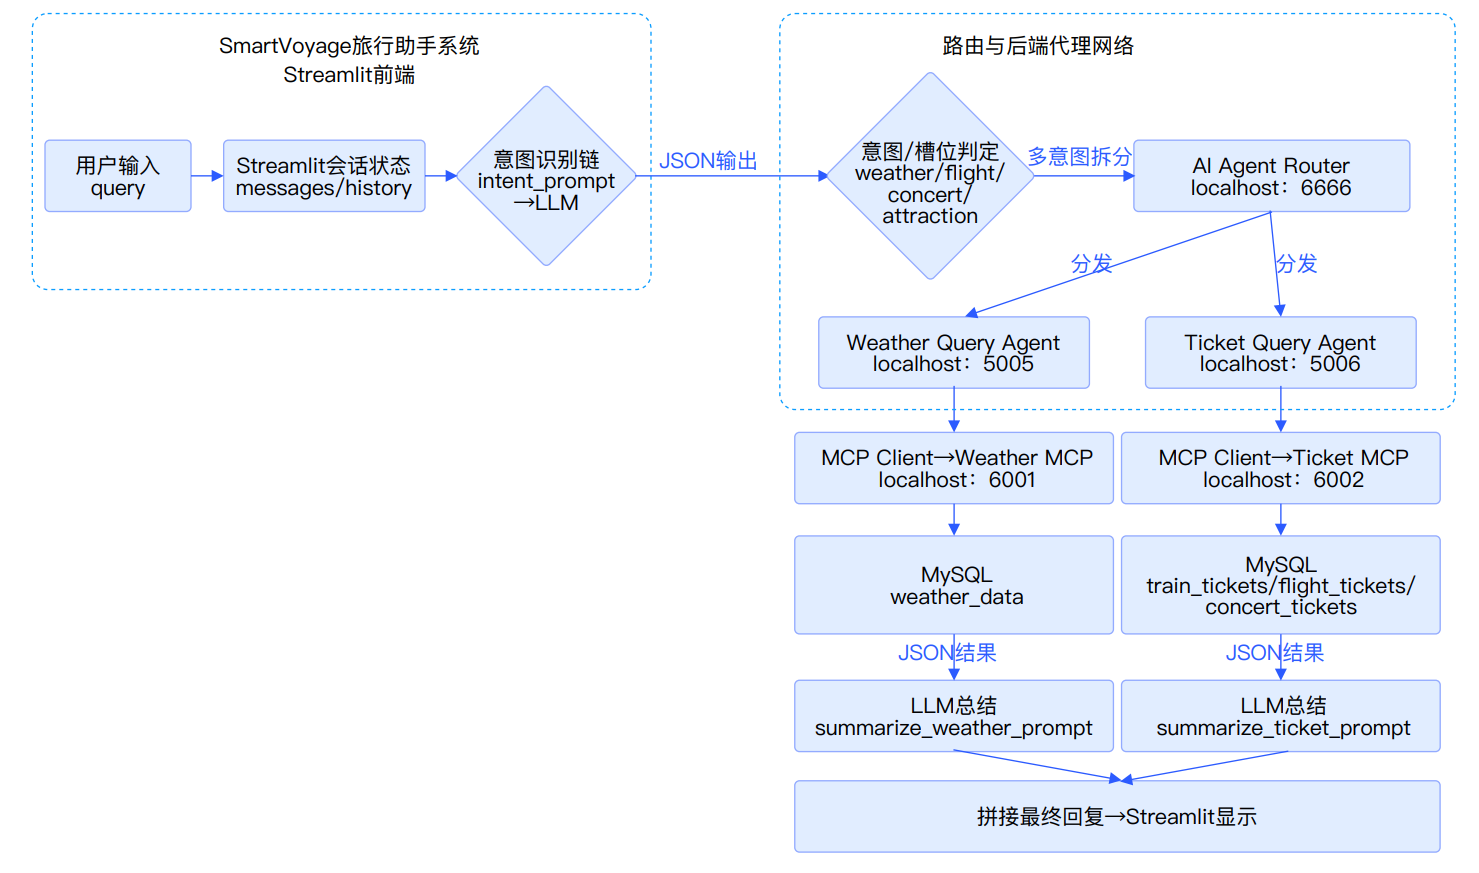
SmartVoyage 是一个智能旅行助手系统,使用 A2A (Agent-to-Agent) 协议构建多代理协作框架,支持用户查询天气和票务信息。系统包括 LLM 路由服务器(意图识别)、天气代理服务器(查询天气数据库)、票务代理服务器(查询票务数据库)、MCP 工具服务器(数据库接口)、数据采集脚本和 Streamlit 前端客户端。用户输入查询(如“北京天气”或“北京到上海火车票”),系统通过 LLM 路由到合适代理,代理生成 SQL 查询 MCP 数据库,返回结果显示在界面。
掌握 A2A 多代理框架开发
掌握意图识别与数据库查询技能
能够完成交互式旅行助手系统的构建
基于Python-a2a协议实现多代理A2A协作框架
使用LangChain+DeepSeek构建LLM路由服务器意图识别与动态路由
实现MCP工具服务器标准化MySQL查询接口
天气代理服务器LangChain SQL生成与MCP实时天气数据库查询集成
票务代理服务器多类型动态SQL生成与结果友好格式化
基于Streamlit开发A2A多代理实时交互前端客户端
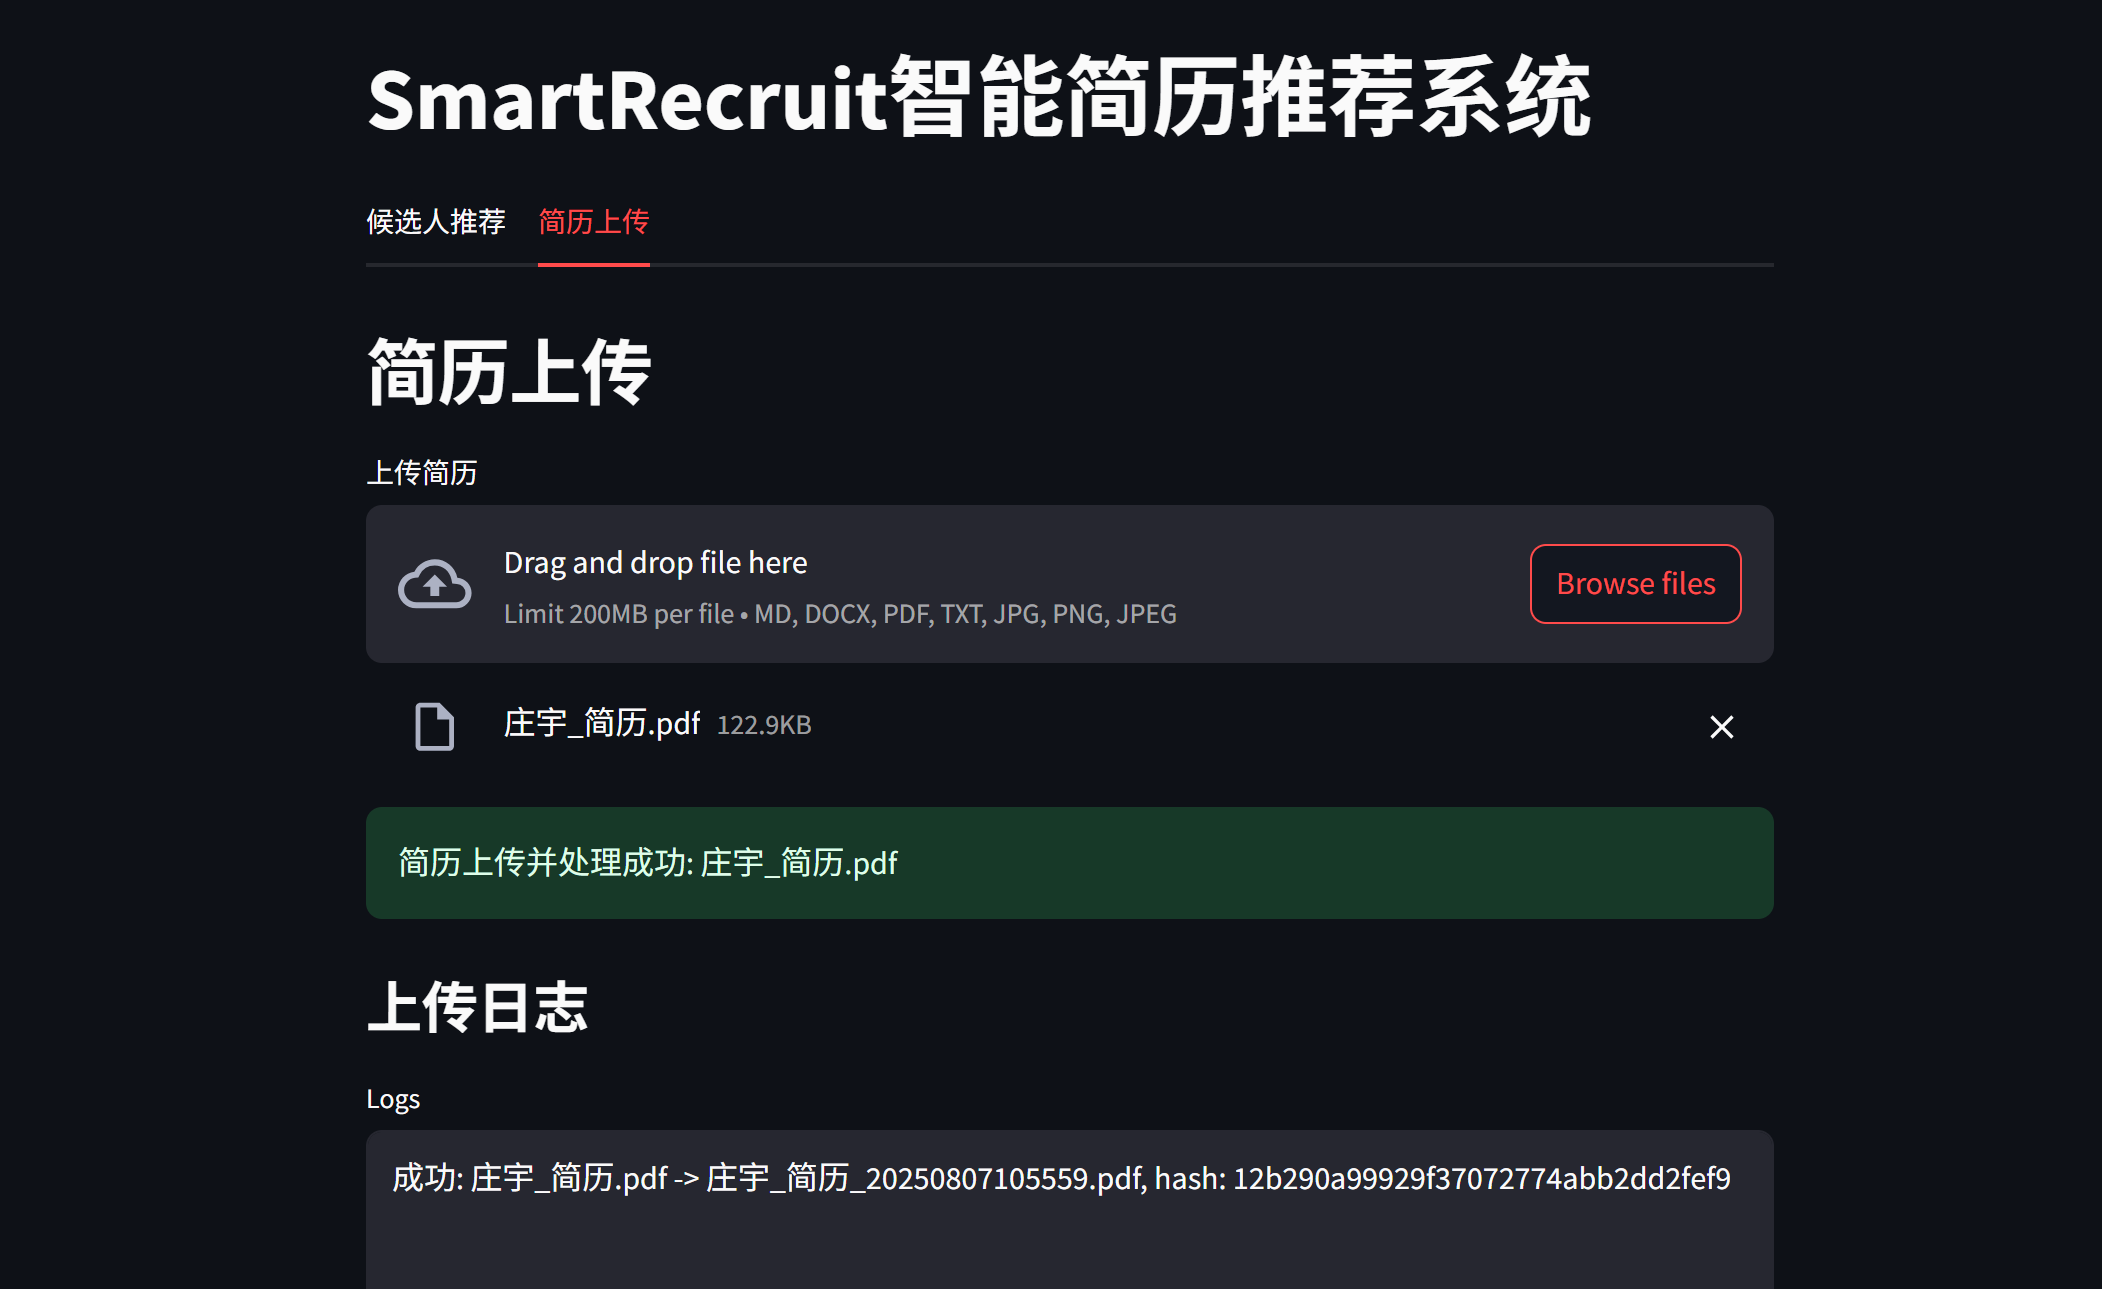
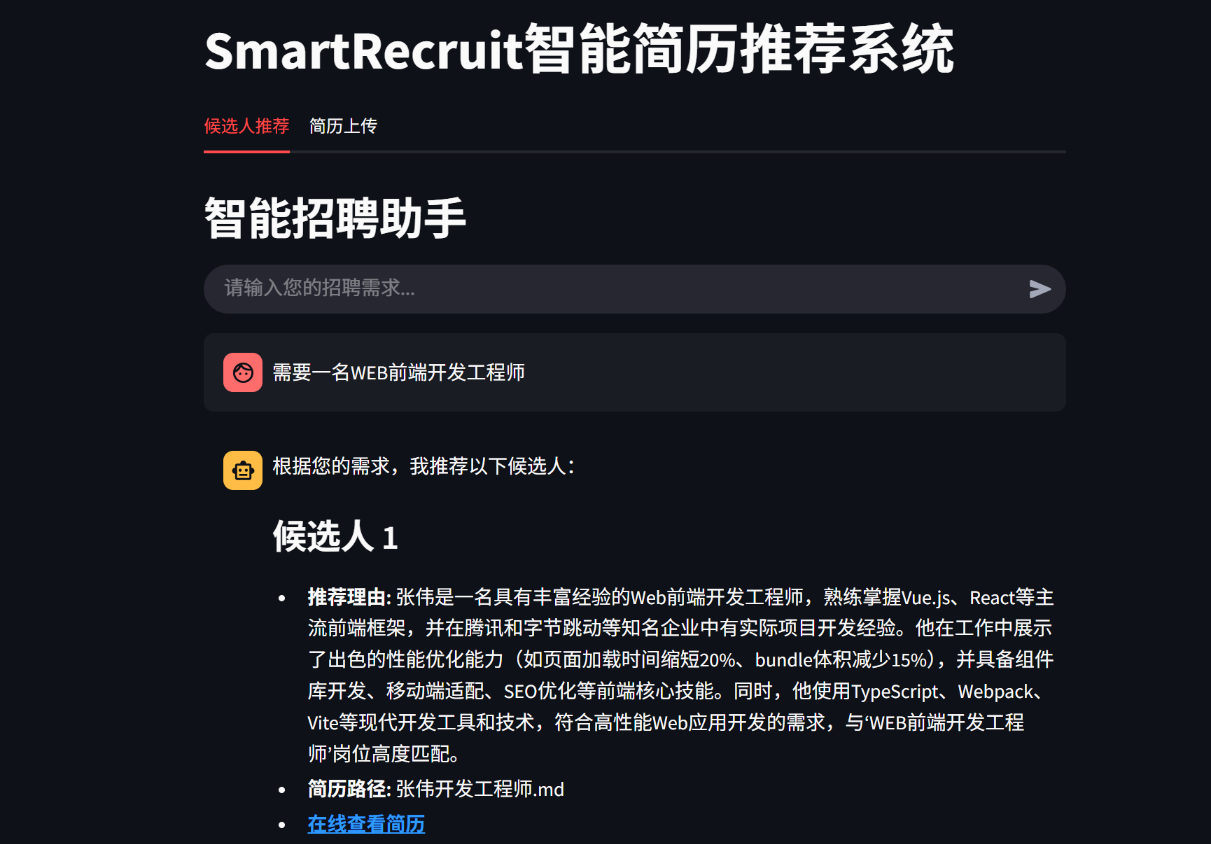
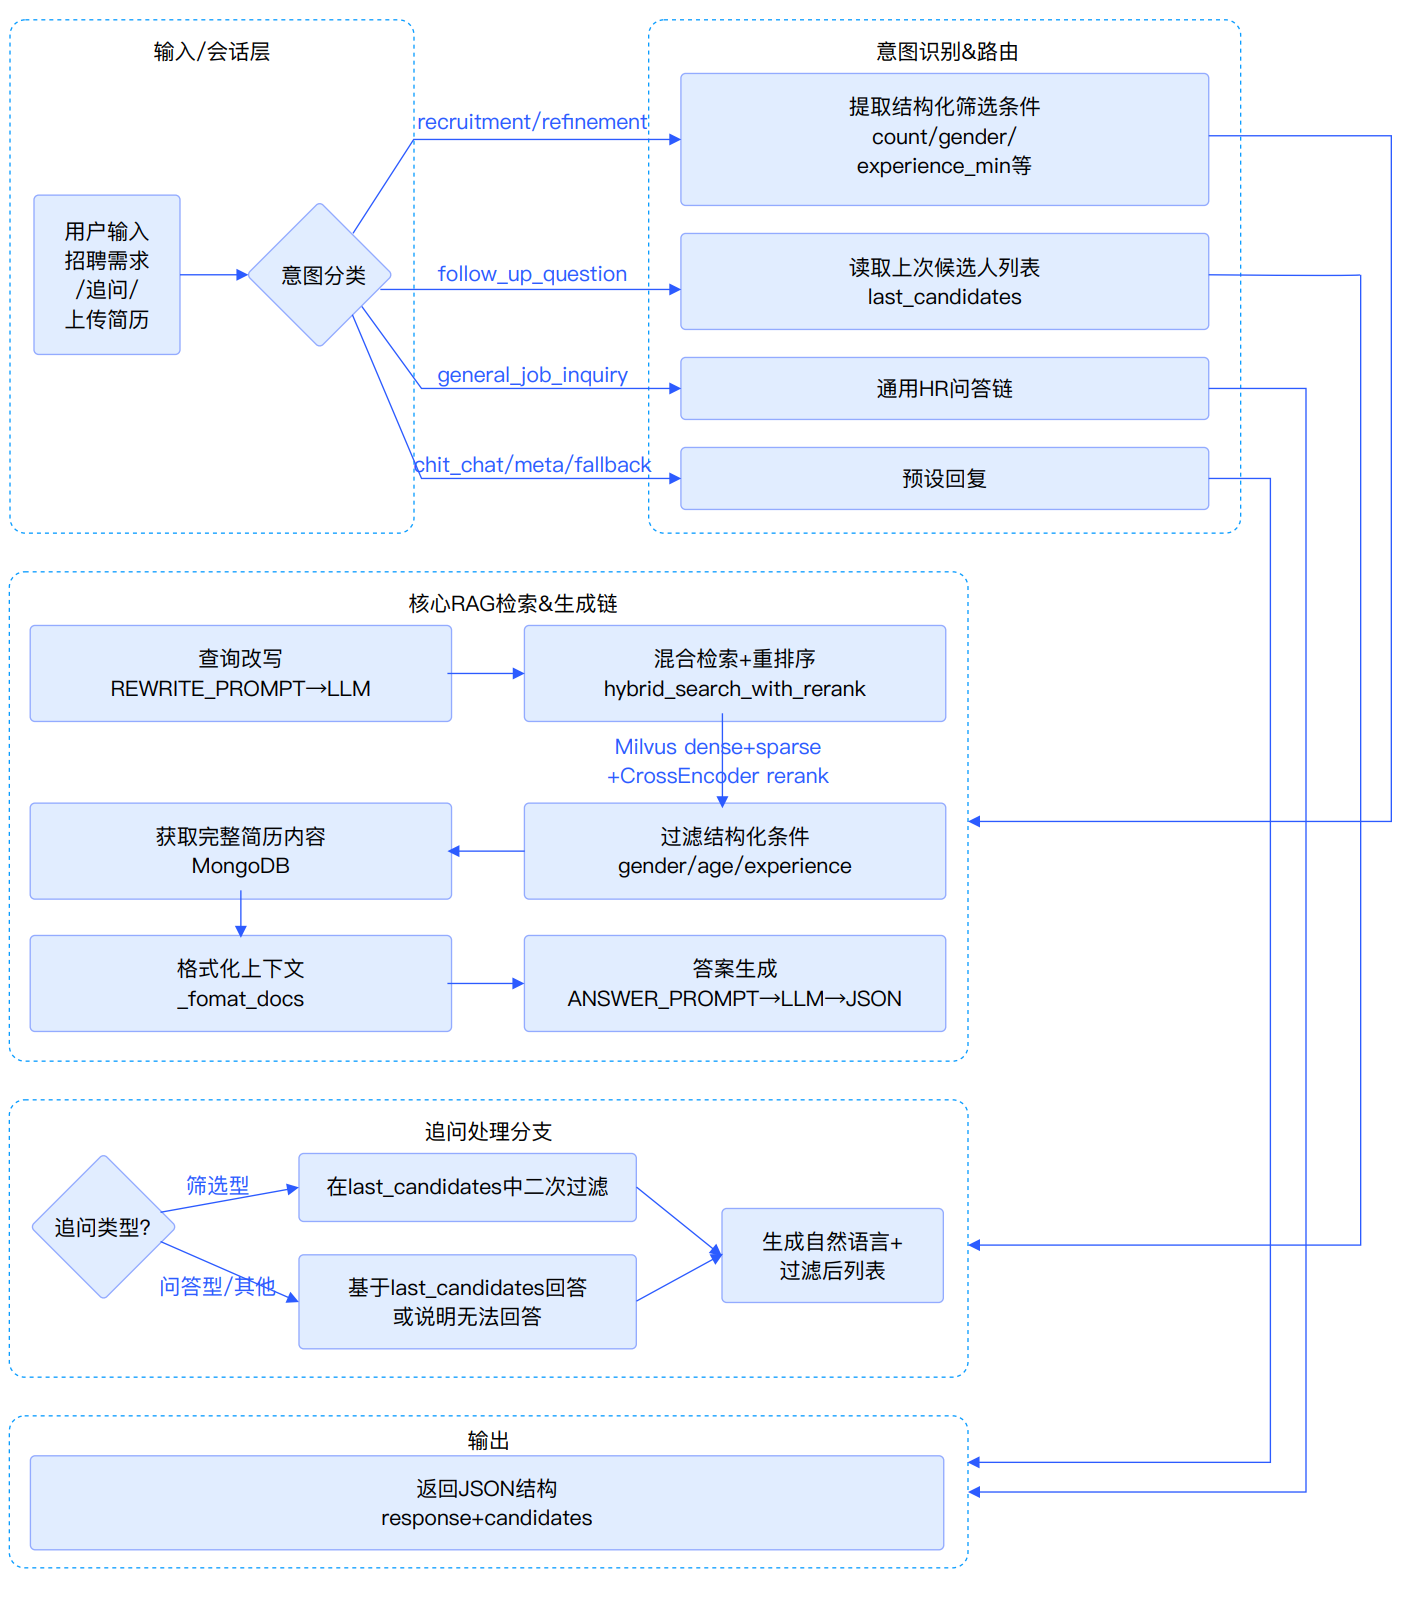
项目基于向量数据库和 LLM 构建一个端到端、可水平扩展的检索增强生成(RAG)系统,支持对异构简历(PDF/DOCX/JPG/PNG)进行自动解析、结构化、语义索引与多轮对话式推荐。系统以向量数据库为核心存储,以 LLM 为推理中枢,以 Agent 框架为调度单元,面向企业 HR 及猎头平台提供秒级、可追溯、可解释的候选人推荐服务。
掌握文档智能处理、向量化索引
掌握RAG 系统开发及 Agent 框架应用
能够完成可扩展的简历推荐系统部署
基于LangChain+OpenAI实现异构简历(PDF/DOCX/JPG/PNG)智能解析与结构化提取
使用Milvus+BGEM3混合嵌入+ElasticSearch实现高级向量索引与多路召回
构建支持参数过滤、查询重写与历史对话的异步RAG链生成JSON候选人推荐
基于SmartRecruitAgent框架实现意图识别、多轮追问与上下文候选人筛选的智能代理
集成Streamlit前端与Milvus/MongoDB/Elasticsearch多数据库持久化的DevOps配置
使用Ragas框架对RAG系统进行端到端Faithfulness/Answer Relevancy/Context
Precision评估优化
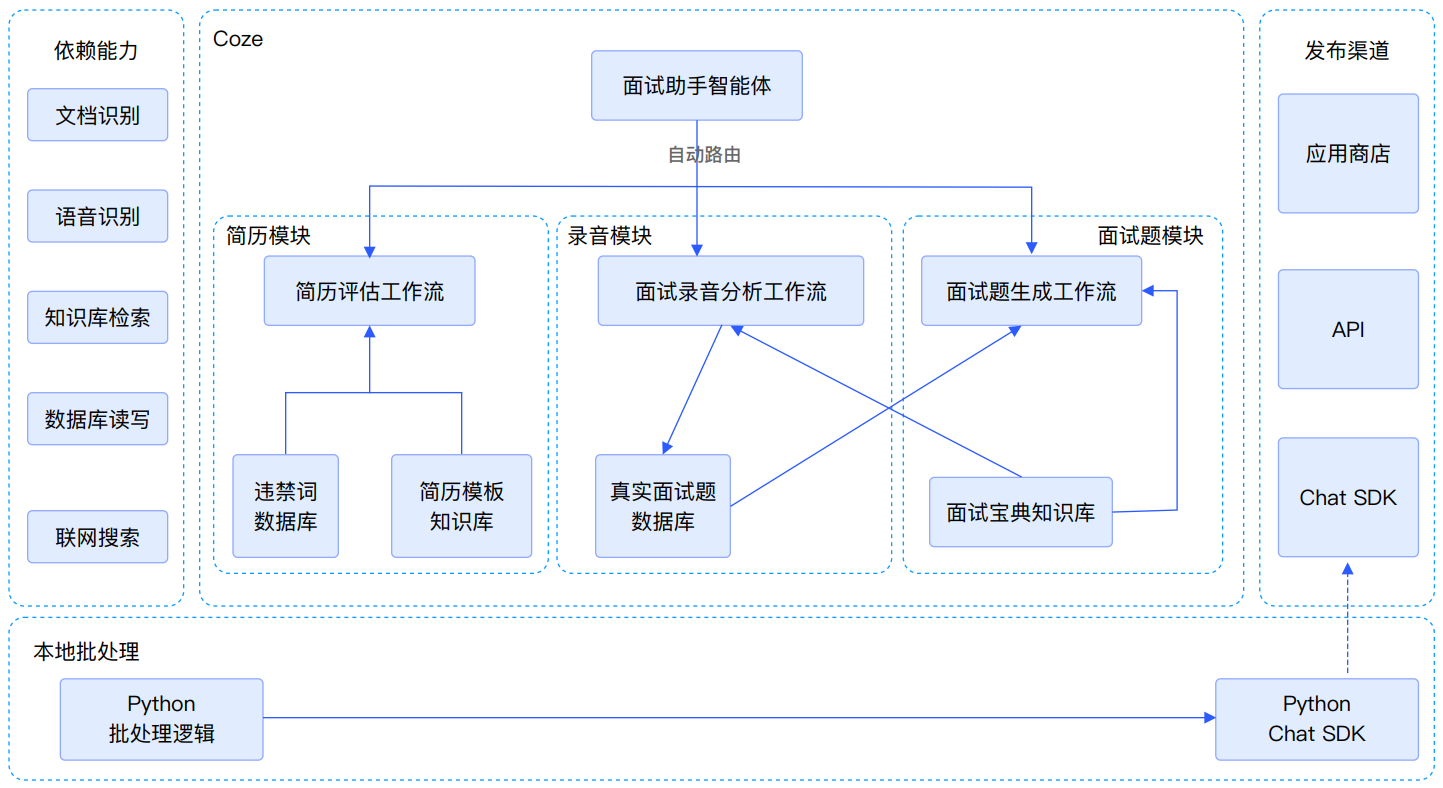
基于Coze工作流平台,结合LLM、ASR、TTS、RAG等技术,为黑马程序员AI学科学生构建面试全流程智能辅助系统,实现简历修改、面试录音分析、个性化面试题生成和实时语音模拟面试等功能。
掌握Coze智能体开发范式
能够独立完成多场景智能体应用的构建与部署
能够实现工作流自动化与业务赋能
实现基于插件完成PDF、DOCX等文档转文本到分析处理的全流程解决方案
实现基于ASR技术实现录音文件转文本到分析处理的全流程解决方案
实现基于知识库结合PDF实现精准内容生成的解决方案
实现在工作流中读写数据库和知识库的解决方案
实现父子模式多Agent架构自主规划执行解决方案
大型ToC企业中的客服团队往往是人力外包,对公司业务细节的了解程度不够,需要和产研团队多次沟通才能完成一次工单的处理,效率低下。 同时,随着AI的发展,工单的处理也可以基于大模型+RAG+funcation call能力进行提效,部分工单自动处理,从而节省部分客服人力资源。 本系统结合大模型能力,融合多种AI技术(RAG+多Agent+MCP)等,结合Kafka消息队列、PostgreSQL向量检索和Docker容器化部署,完成大型企业工单的判定、处理、建议与知识库实时迭代等全流程流转闭环,解决传统客服流程低效问题。
掌握企业级智能工单系统架构设计
能够实现基于规则过滤、查询改写、意图识别的全流程自动化处理
能够具备复杂业务场景下多智能体系统的开发与运维能力
使用无侵入的方式实时处理业务系统数据的解决方案
实现企业私有化数据脱敏的解决方案
实现基于多层模型实现复杂分类的解决方案
实现基于RAG+MCP调用实现融合知识库+API的上下文工程的解决方案
实现动态更新知识库的解决方案
实现docker镜像构建和服务器部署的企业部署解决方案
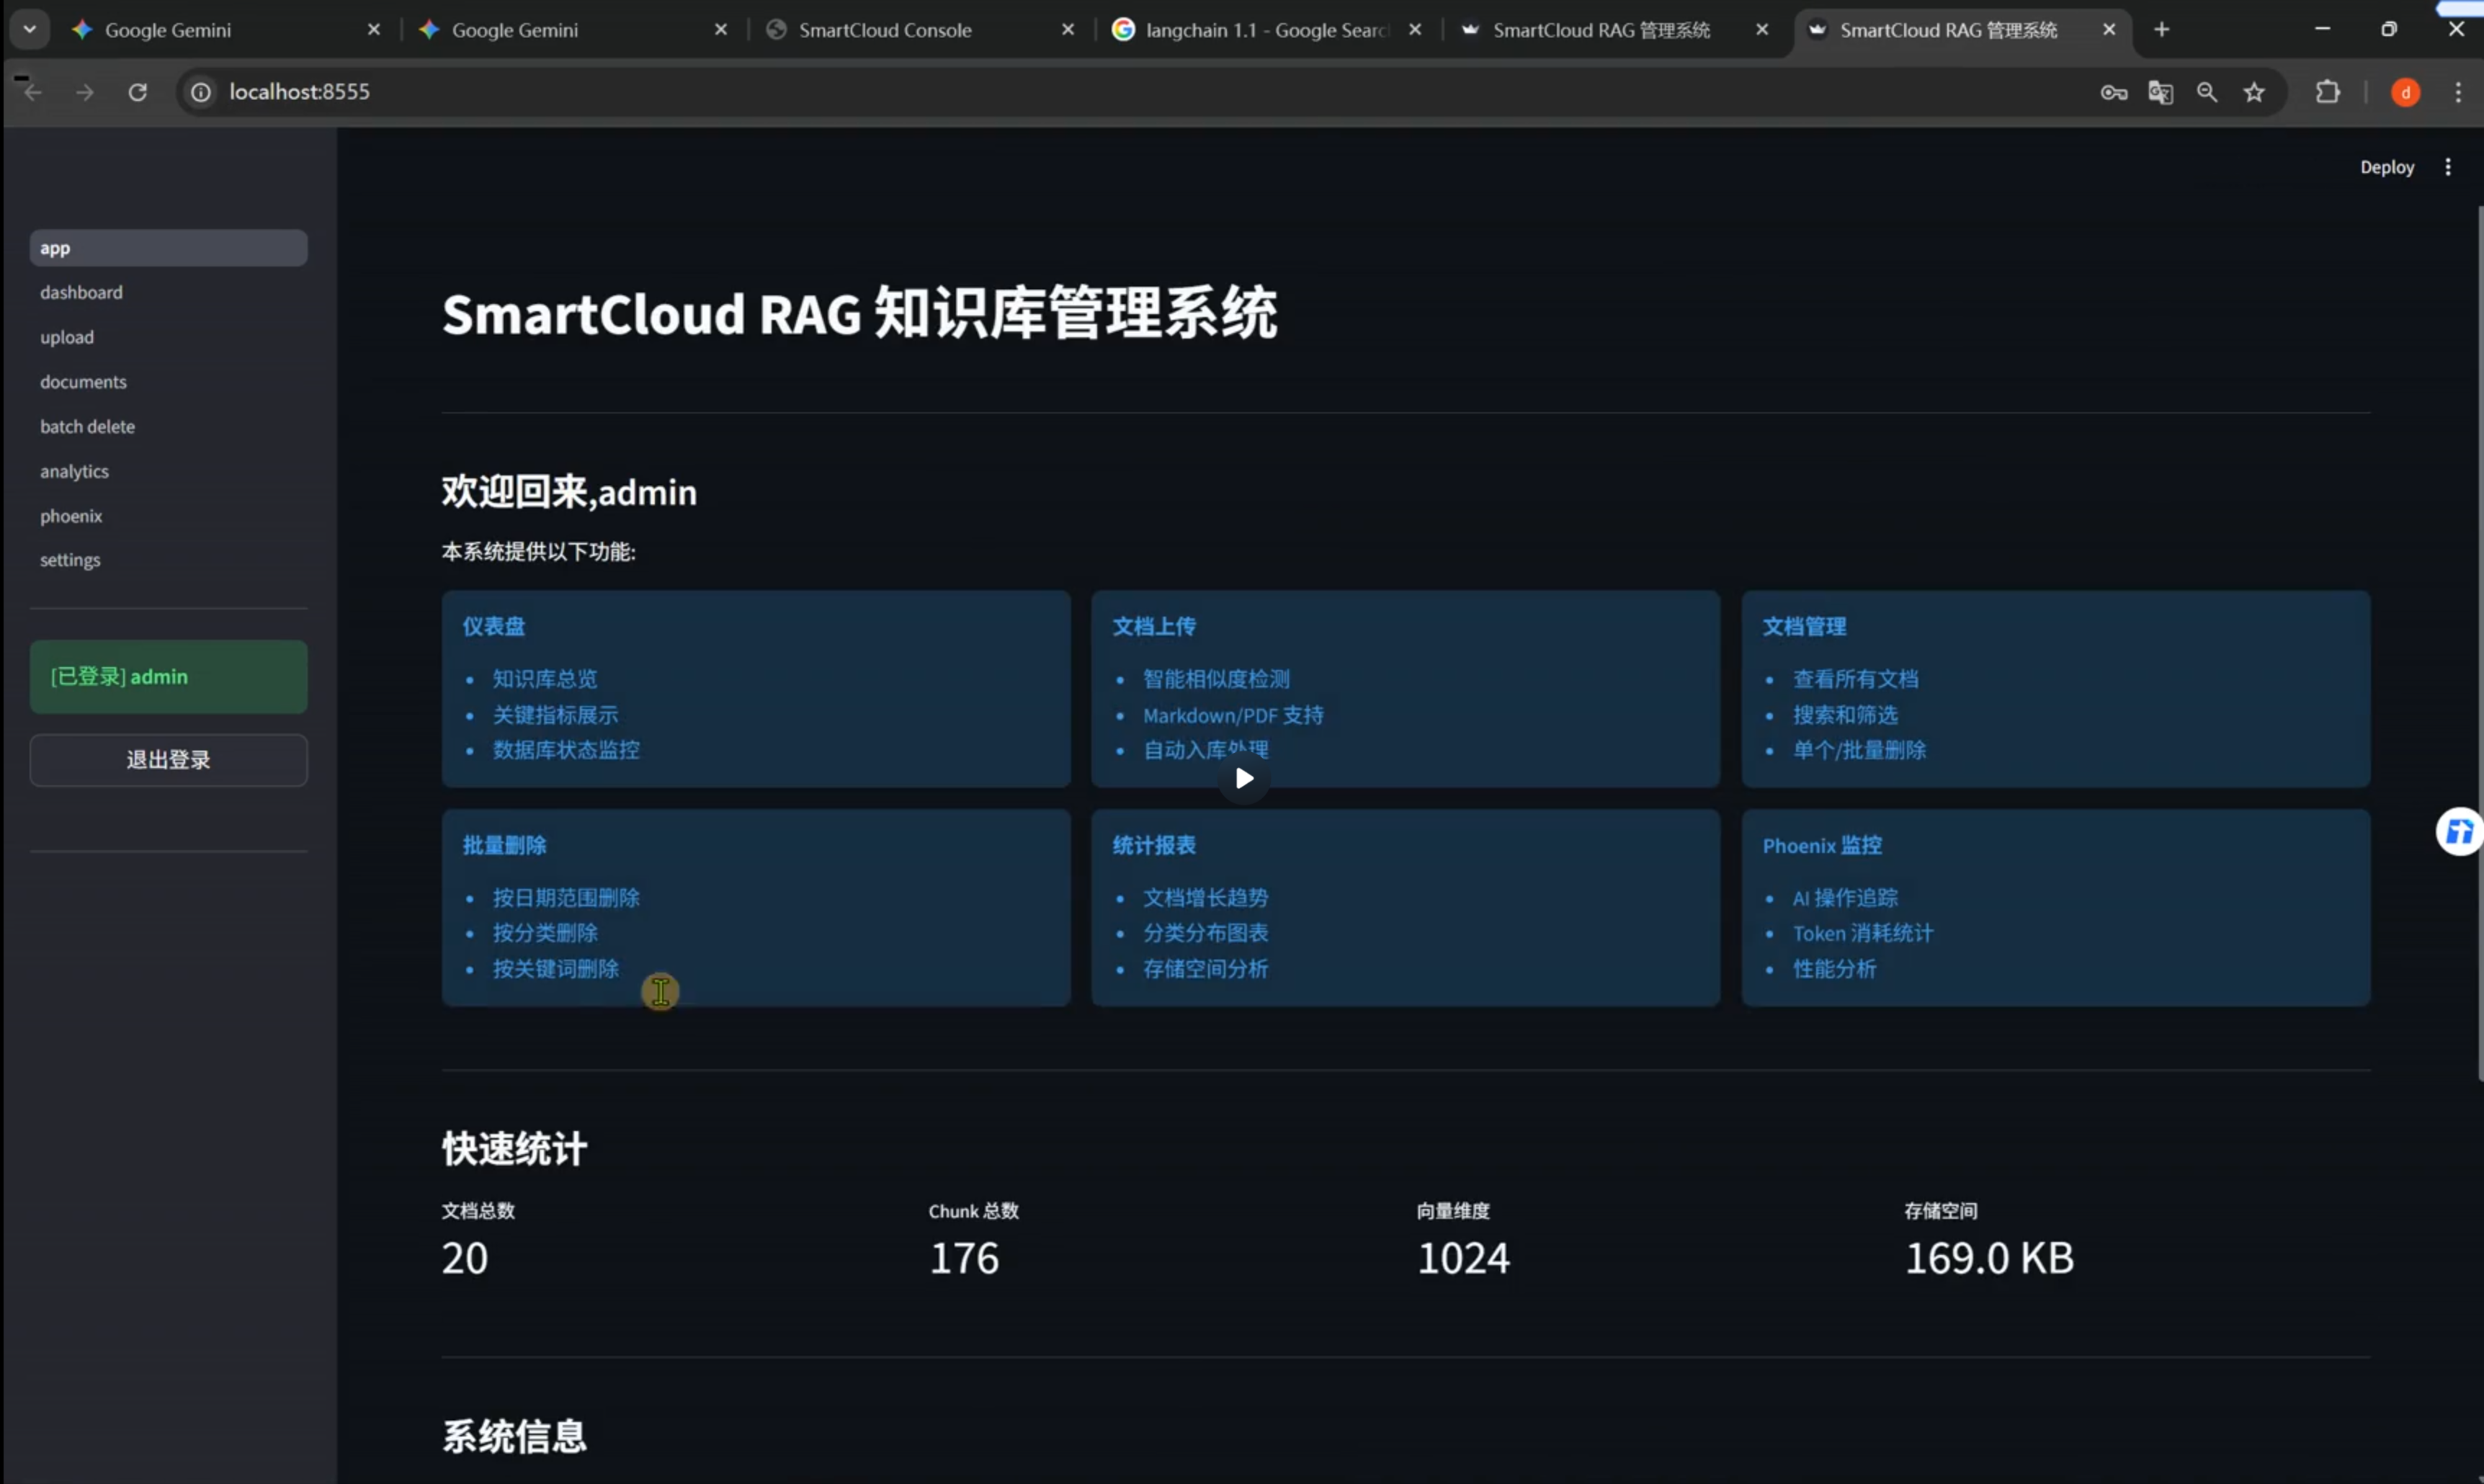
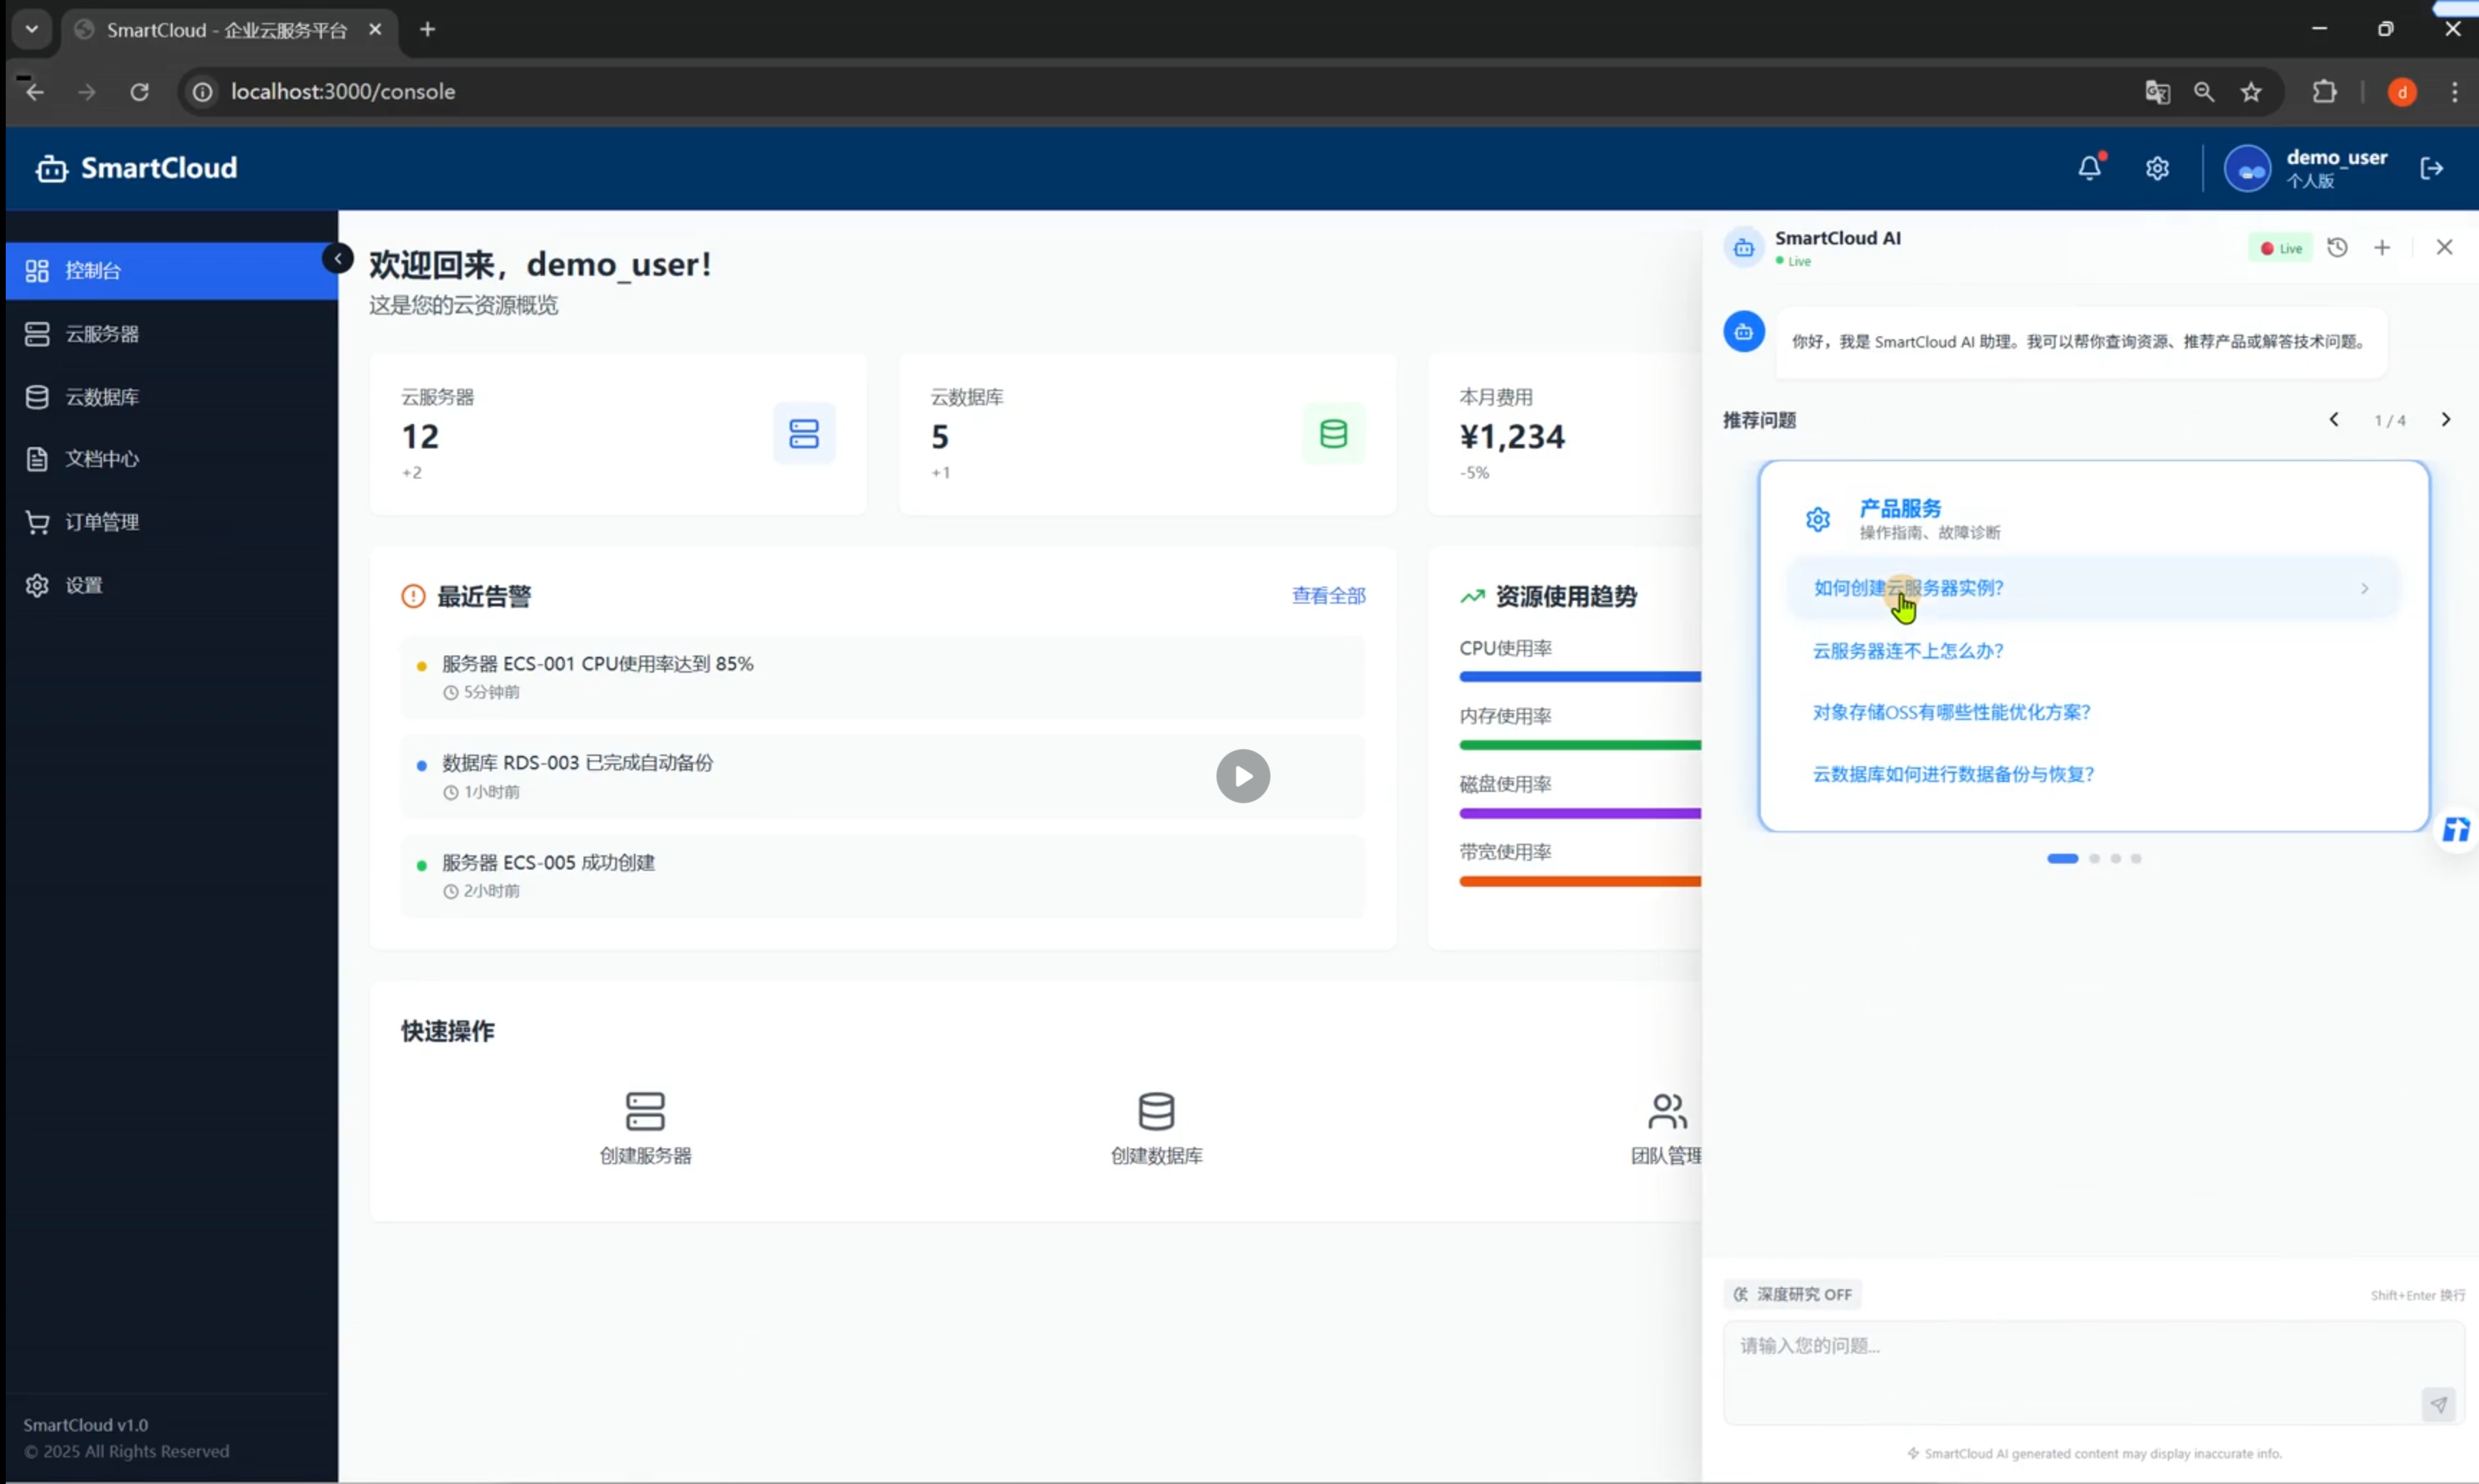
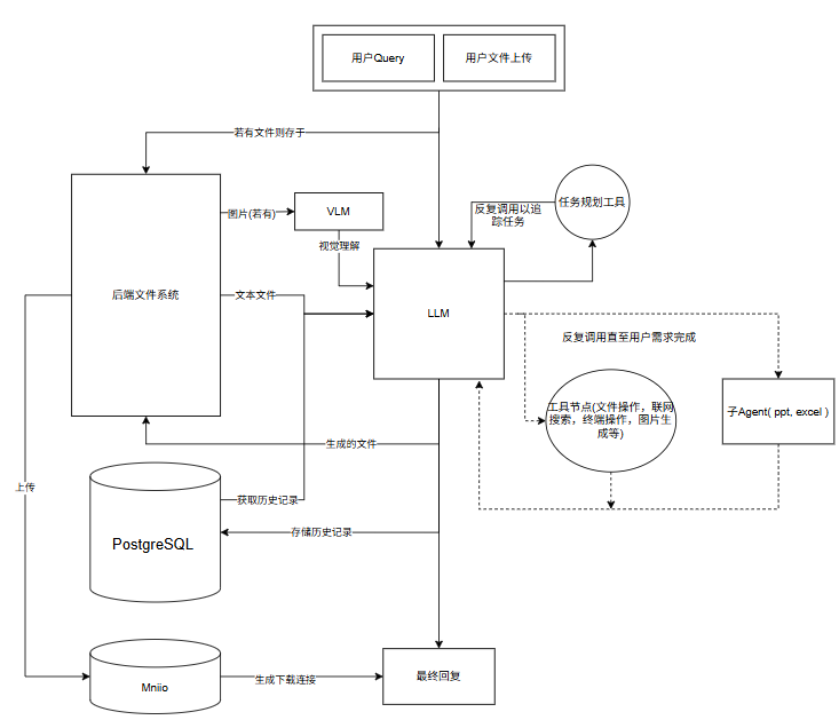
通用智能体作为该领域的高阶形态,其开发能力可为各类垂直场景的智能体构建提供坚实基础与技术范式。本项目基于 Langchain 1.0 框架,集成了 MCP 协议、多模态处理及联网搜索等前沿技术,是理解和构建复杂智能体平台的实战标杆。项目旨在构建一个基于 LangChain 生态的通用 Agent 平台,实现自主任务规划、多模态交互及联网搜索功能,支持多用户并发,具备极强的扩展性。
构建智能代理中枢:实现工具调用、自主任务规划及深度上下文理解。
实现全模态覆盖:支持主流办公文档(PDF/Word/Excel/PPT)及图片的双向处理。
集成实时信息检索:通过 Tavily API
实现联网搜索,确保信息的时效性与准确性。
提供企业级架构:支持多用户、多会话,提供完善的监控与追踪能力。
先进的技术栈:基于 LangChain v1.0,代表了当前 Agent 开发的主流趋势。
开箱即用的多模态能力:内置对多种办公文档的支持,极大降低了多模态应用的开发门槛。
高度可扩展的架构:模块化设计支持自定义工具、中间件及子代理,方便二次开发。
完善的可观测性:集成
LangSmith,提供全链路的追踪、评估和监控,确保生产环境稳定。
容器化快速部署:支持 Docker & Docker Compose,一键启动,环境一致性高。
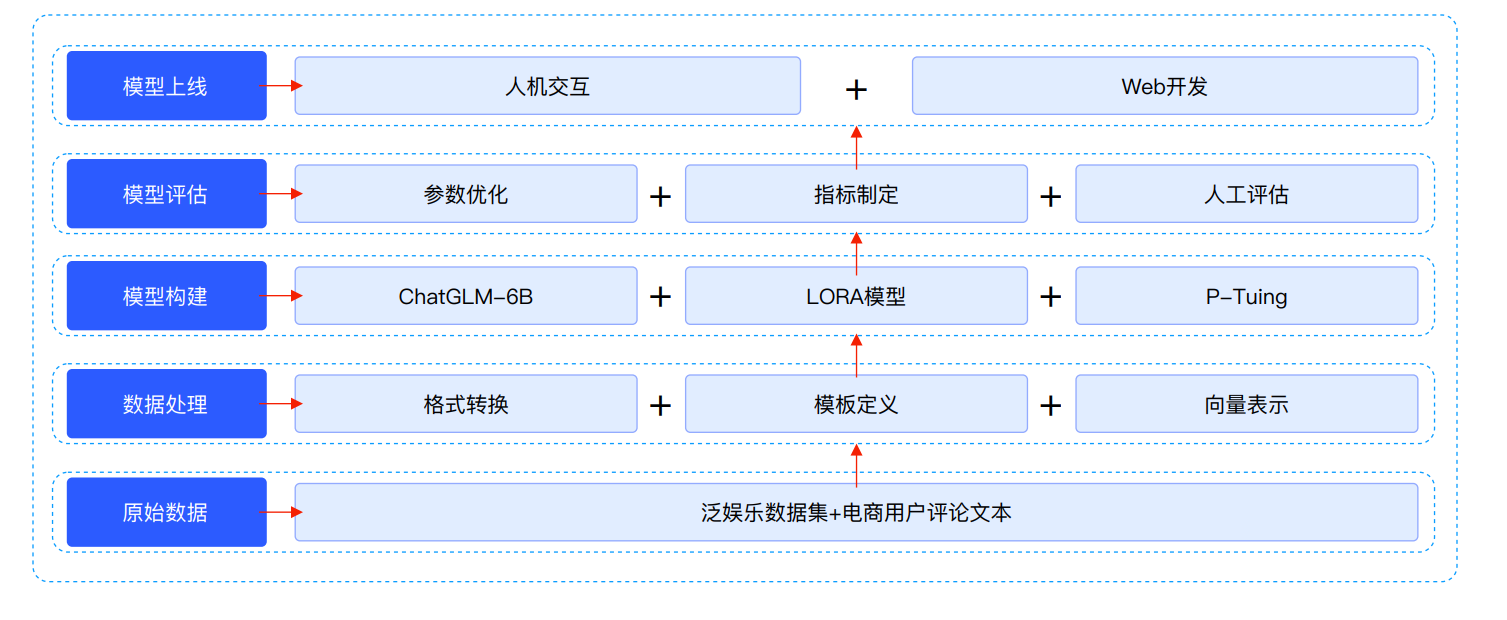
基于ChatGLM/QWen+LoRA微调实现微博文本信 息抽取+文本分类的多任务,通过一个大模型 同时解决多种任务开发和应用,项目基于LLM 进行混合任务开发应用的实现,利用 ChatGLM/QWen大模型进行P-Tuning微调的方 式,基于Flask框架实现API接口开发和应用。
了解和掌握大语言模型的基本原理和架构,特别是ChatGLM/QWen模型的结构和工作机制。
掌握大模型LoRA微调技术,通过微调预训练的大模型来适应特定任务的需求。
掌握大模型P-Tuning微调技术,对大模型进行高效的参数调整,增强其在特定任务上的表现。
理解和应用多任务学习的概念,通过一个模型同时解决文本信息抽取和文本分类两种任务,提高模型的综合能力和应用效率。
掌握文本信息抽取技术,从非结构化的文本数据中提取有价值的信息,如实体、关系、事件等。
学习文本分类的基本原理和方法,掌握如何将文本数据按照预定义的类别进行归类。
通过Flask框架,学习如何开发和部署API接口,使模型能够通过网络服务被访问和使用。
联合任务数据预处理适配模型训练的解决方案
实现ChatGLM/QWen+LoRA训练的解决方案
实现ChatGLM/QWen+P-Tuning训练的解决方案
基于Flask框架实现模型API接口开发的解决方案
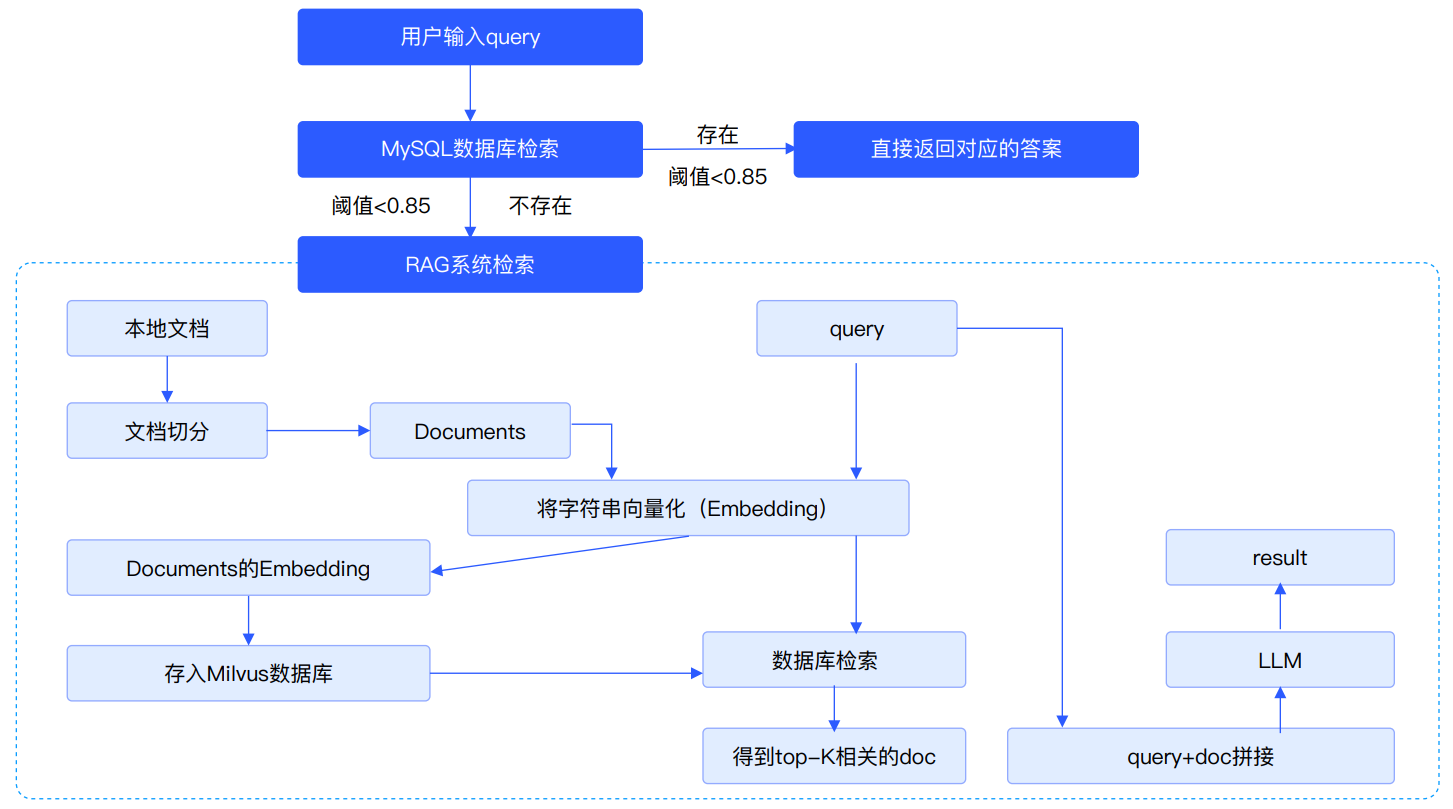
EduRAG 是一个企业级智能问答系统,专为教育场景设计,整合了基于 MySQL 的快速 FAQ 检索和基于 RAG(Retrieval-Augmented Generation)的复杂问题处理能力。系统通过结合 MySQL 数据库的高效查询和 Milvus 向量数据库的语义检索,实现了从常见问题到专业咨询的全方位问答支持。系统支持多来源过滤(如 AI、Java、测试、运维、大数据),并通过 Redis 缓存优化性能,使用 LLM 提供高质量答案生成。
了解LangChain基本概念、明确LangChain主要组件的作用、了解LangChain常见的使用场景
掌握基于LangChain+ChatGLM-6B模型实现本地知识库的问答实现原理+过程
RAG 系统开发与优化:掌握从数据分片到答案生成的 RAG 全流程,熟练应用
HyDE、子查询等检索增强策略提升系统性能。
大模型应用实践:能够集成 LLM(如 OllamaLLM)并设计高效
Prompt,解决知识问答中的业务定制化需求。
智能查询路由设计:实现规则、相似度和 LLM
三层路由,精准分发查询并优化复杂意图识别效率。
后端服务与前端开发:使用 FastAPI 开发高并发 API 并通过 Gradio
构建交互界面,满足企业级服务与用户体验要求。
数据处理与多源集成:熟练处理结构化与非结构化数据,结合 MySQL
和向量搜索打造高效知识检索系统。
企业级问题解决能力:通过日志调试和高并发设计,具备定制化开发与性能优化的实战技能,适配智能客服等场景。
数据库查询优化:BM25 + Redis 缓存
语义检索:Milvus 混合向量检索
查询分类:BERT 分类器
动态检索策略:LLM 驱动的策略选择(直接检索、HyDE、子查询、回溯)
答案生成:LLM + RAG 提示模板
性能优化:Redis 缓存 + 模块化设计
日志与监控:统一日志系统(logging)
配置管理:ConfigParser + config.ini
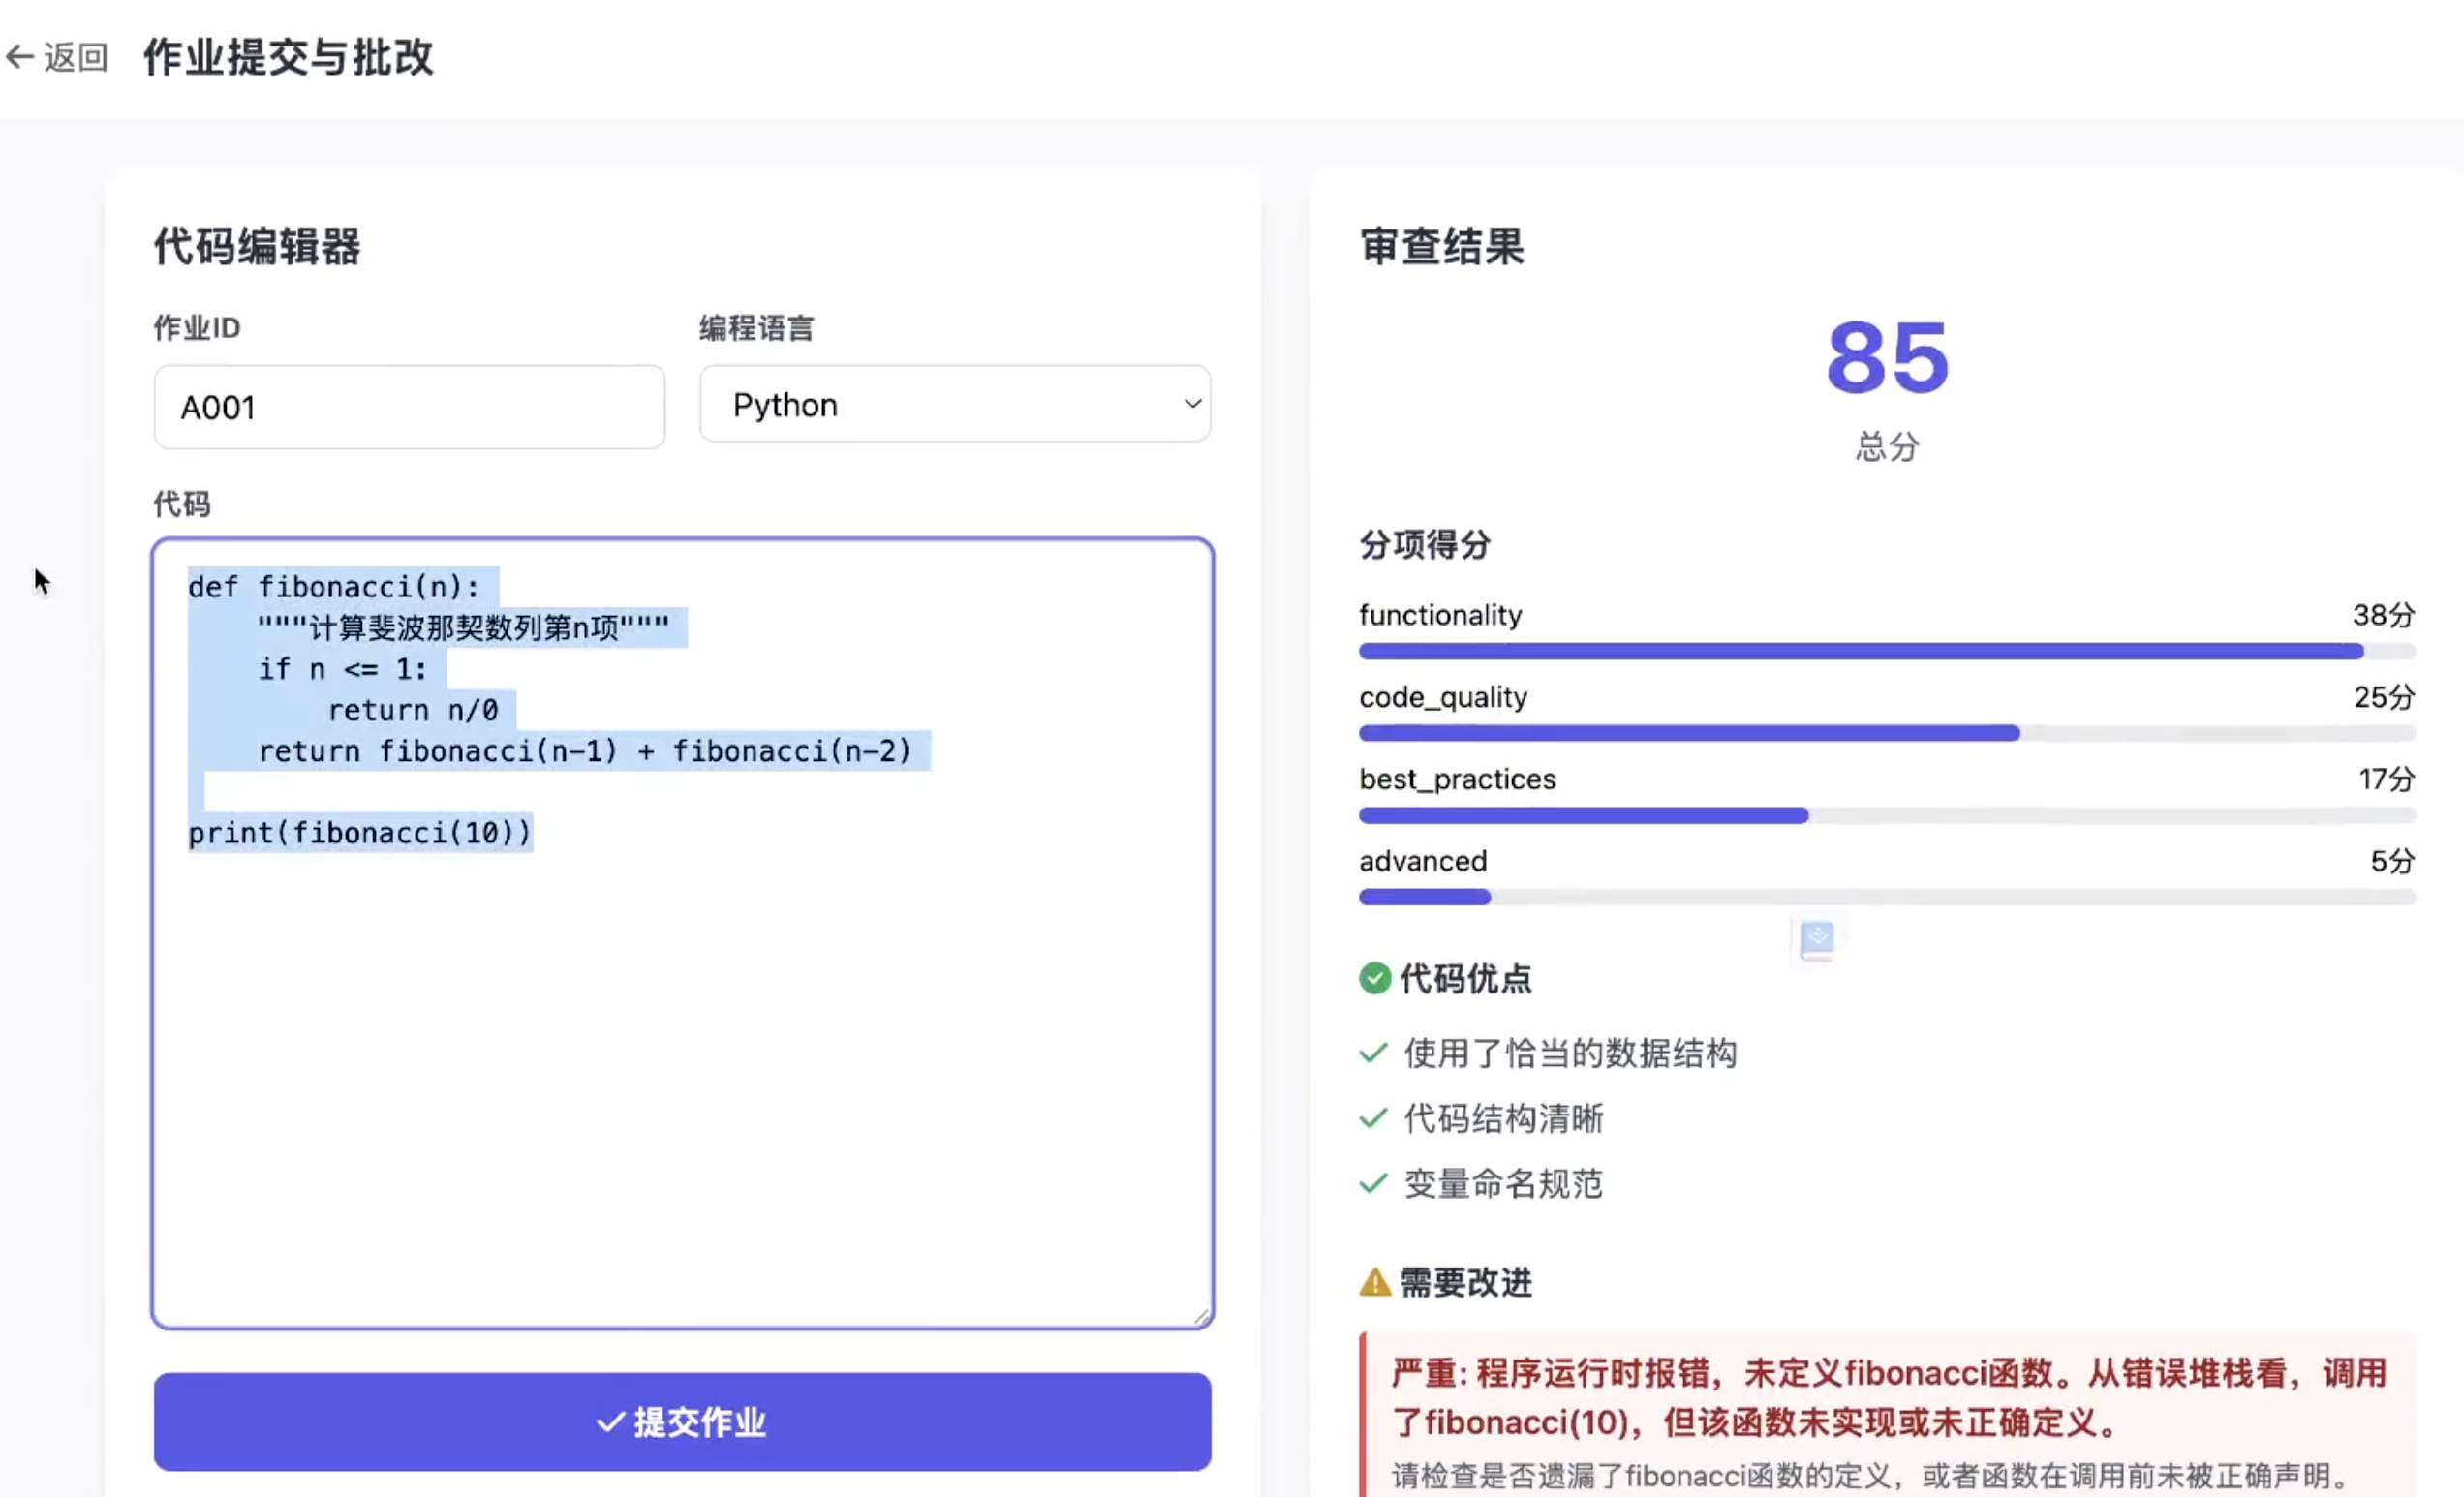
EduAgent项目基于LangChain、LangGraph和FastAPI构建。系统提供智能问答、代码审查、个性化学习路径规划和职业咨询等核⼼功能,旨在为在线教育场景提供全⽅位的AI辅助教学解决⽅案
基础设施:⼀键docker-compose启动全环境,PostgreSQL、Milvus、Redis、MinIO、
Judge0 全部就绪
公共能⼒层:LLM
Factory多模型路由、BGE-Reranker精排、MiniLM意图分类,全部可独⽴调⽤
四⼤Agent:智能问答、试卷批改、简历审查、模拟⾯试,端到端流程完整跑通,异常处理与降级策略覆盖到位
前端集成:Vue3界⾯与后端API全⾯对接,SSE流式输出流畅,三级⻆⾊权限路由隔离完整
集成测试:核⼼流程覆盖率达标,三层兜底降级机制验证通过,并发压测⽆崩溃
教育场景多租户数据隔离解决⽅案:所有PostgreSQL表预埋tenant_id,Milvus
Collection按租户namespace隔离,⽀持多班级、多课程独⽴运营
⾼精度RAG冷启动与持续迭代解决⽅案:初始知识库由课程资料清洗⼊库,检索链路采⽤混合召回+精排+置信度过滤,低置信度问答⾃动进⼊补充队列,教师在线添加后热更新知识库
复杂批改任务的三轨并⾏加速解决⽅案:试卷批改Agent中,客观题规则引擎、简答题LLM分组并⾏、代码题Judge0执⾏+LLM评估三条轨道通过asyncio.gather并发执⾏,整体批改耗时降低60%以上
Human-in-the-Loop教师确认解决⽅案:利⽤LangGraph的interrupt()挂起批改结果,教师登录后逐题确认或修改,通过Command恢复图执⾏,并集成企业微信机器⼈⾃动推送待确认通知
国产模型低成本切换与降级解决⽅案:LLM Factory封装DeepSeek-V3(通⽤)和
DeepSeek-Coder-V2(代码),⽀持配置热切换;三层兜底机制(重试→降级模型→预设回复)保障LLM服务异常时的系统可⽤性
本地开发到⽣产环境的平滑迁移解决⽅案:本地使⽤Docker Compose +
MemorySaver+MinIO,⽣产环境仅需修改配置(AsyncPostgresSaver、阿⾥云
RDS/OSS、K8s 部署),业务代码零改动,⽀持⼀键迁移

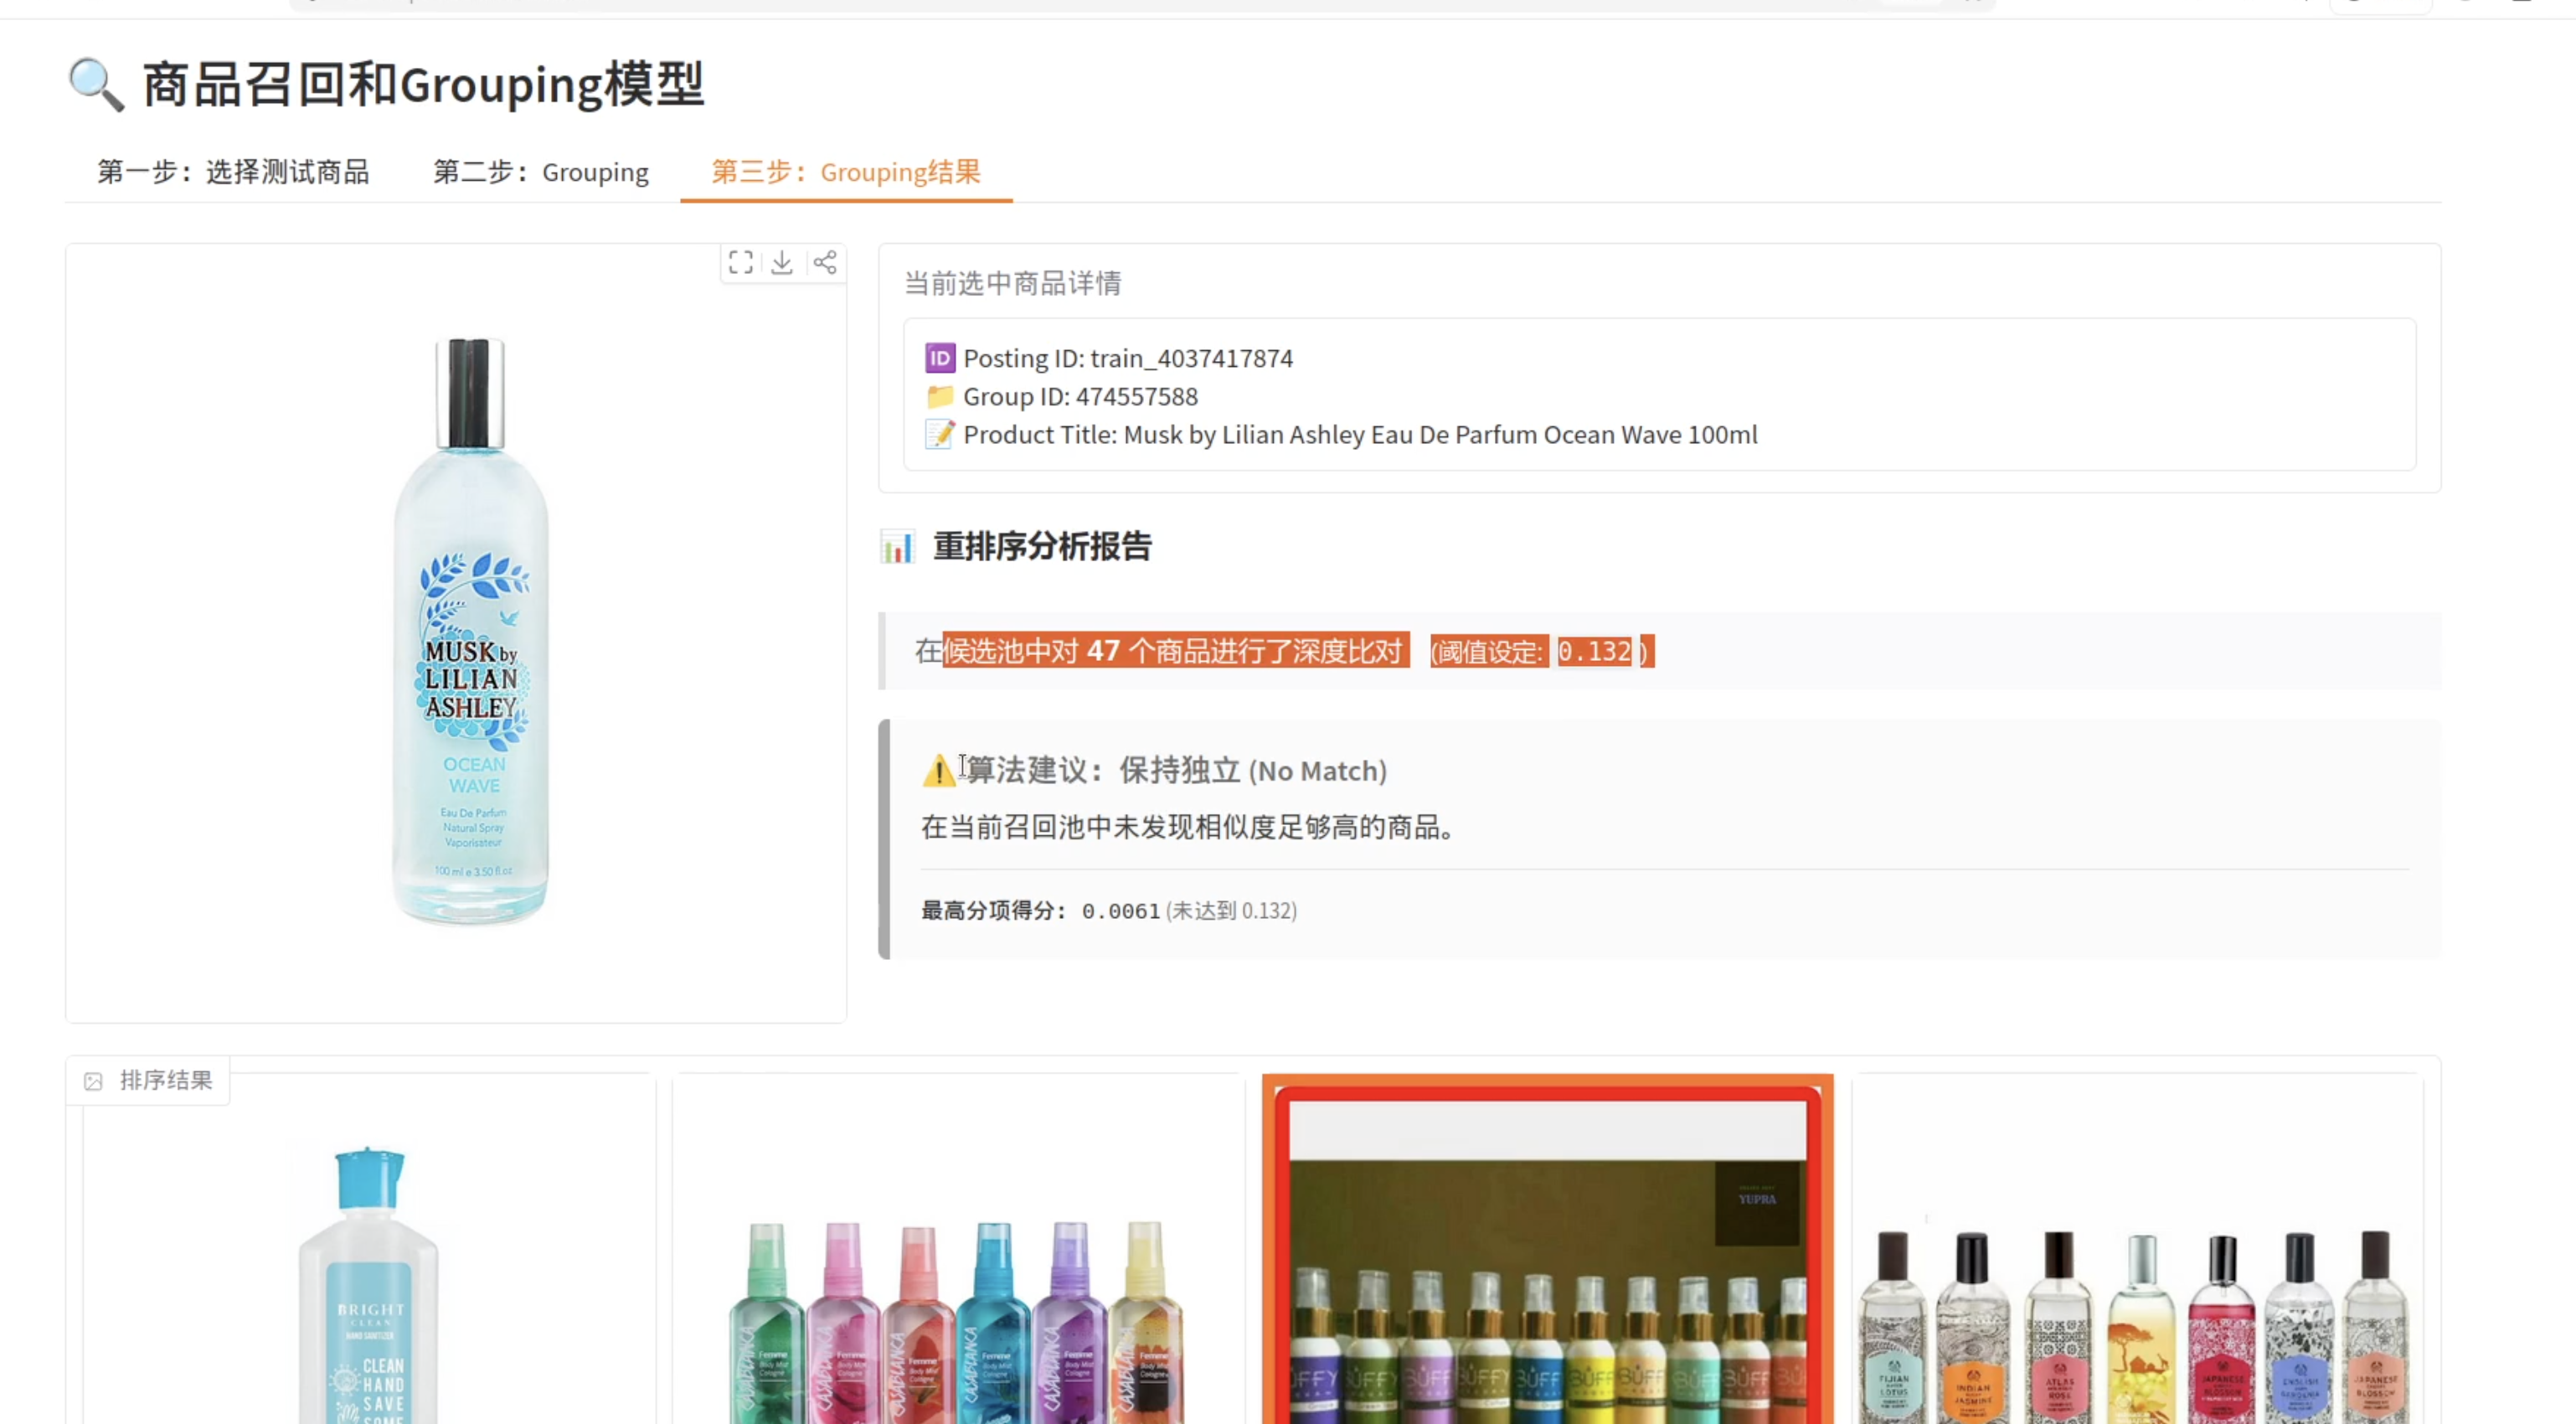
项⽬以“电商商品聚合与⽐价”为核⼼业务场景,解决电商场景中多源、异构商品数据的标准化处理、⾼精度分类与智能聚合难题
环境与⼯程搭建能⼒:熟练搭建Linux开发环境,吃透模型微调完整流程,精通PyTorch
与HuggingFace⽣态,具备⼯业级算法项⽬搭建基础能⼒
电商数据处理能⼒:掌握电商商品数据集制作、⼤模型少样本预标注、主动学习降本、难负样本挖掘,独⽴完成业务数据清洗与优化
多模态模型微调能⼒:精通商品分类、向量召回、同款聚合聚类三⼤任务,熟练运⽤对⽐学习、度量学习、LoRA⾼效微调,可独⽴微调图⽂多模态模型
主流算法与⼯具实战能⼒:掌握双塔/交叉编码器架构、FAISS向量检索、⾃动超参调优,能⽤LlamaFactory实战微调视觉⼤模型,⾃定义训练逻辑与评估指标
模型推理部署落地能⼒:掌握模型量化、推理加速、注意⼒优化,可快速搭建交互式演示项⽬,完成多模态⼤模型从训练、调优到线上部署全流程落地
低成本⾼质量数据集构建解决⽅案
使⽤Optuna进⾏⾃动超参数寻优解决⽅案
多模态⼤模型微调解决⽅案
多模态⼤模型推理部署解决⽅案
多模态⼤模型推理优化解决⽅案
基于⼈⼒资源招聘⾏业垂直⼤模型与知识图谱融合检索解决⽅案,通过项⽬学习完成企业级招聘检索系统全流程开发、部署、测试与优化。从Transformer底层原理、⼤模型 SFT+DPO双阶段微调、LangGraph智能体构建、招聘职位实体要素抽取及图谱关系构建,结合实时数据⼯程组件写⼊职位实体到检索引擎,完成招聘AI检索系统构建
招聘领域⼤模型微调能⼒
⼤模型服务化部署能⼒
LangGraph 智能体开发能⼒
招聘知识图谱构建能⼒
搜索意图识别匹配能⼒
Kafka+Flink实时数据流处理能⼒
基于Kafka消息队列实现业务解耦能⼒
搜索推荐(Sug)构建能⼒:基于实体图谱的搜索词补全
招聘领域⼤模型 SFT+DPO 双阶段微调解决⽅案
基于 LangGraph 的招聘智能体与知识图谱构建解决⽅案
招聘搜索意图识别与实体抽取解决⽅案
⼤模型 vLLM ⾼性能推理部署解决⽅案
ElasticSearch+Redis ⾼并发职位检索解决⽅案
基于实体图谱的搜索词推荐(Sug)解决⽅案
⼤模型训练显存优化(ZeRO / 梯度检查)解决⽅案
招聘检索 badcase 治理与相关性优化解决⽅案
汇聚海内外大模型硕博名师
实力比肩国际一流师资水平
全方位教学服务 助你赢在职场
课程大纲
入门试学班
1. 大模型开发入门
高手班
1. 大模型语言进阶 2. 提示词工程 3. 智能体平台开发 4. 大模型核心开发技术 5. NewsCompass投满分项目 6. 大模型RAG开发 7. RAG项目(2选1) 8. 大模型智能体定制开发 9. Agentic Workflow(2选1) 10. Agent Loop(3选1) 11. Agent Harness 12. 大模型微调开发基础 13. 微博文本信息抽取和摘要 14. 大模型微调综合项目(2选1)
赠送
1. 图像分析基础 2. 多模态大模型应用开发
AI大模型开发V6.5版本
课时:8天 技术点:60项 测验:1次 学习方式:线下面授
理解⼤语⾔模型基本原理| 熟悉主流⼤模型及应⽤场景| 掌握Prompt提示词设计⽅法| 理解Agent、RAG、Workflow掌握Coze智能体开发| 掌握知识库与RAG应⽤| 掌握插件与⼯具调⽤| 掌握⼯作流编排与应⽤| 掌握Python基础语法| 掌握流程控制与容器操作| 掌握函数的定义与调⽤掌握⽂件及异常处理| 理解Vibe Coding开发模式| 熟悉AI编程⼯具使⽤| 掌握⼤模型与知识库接⼊能够完成基础AI项⽬开发
1. AI⼤模型概述零基础入门AI大模型开发的开始,包含了以下技术点:
什么是⼤语⾔模型(LLM)| ⼤模型能做什么(⽂本⽣成、对话、推理、翻译、摘要)| 主流⼤模型介绍(GPT系列、Claude、通义千问、⽂⼼⼀⾔、 DeepSeek等)| ⼤模型的边界与局限(幻觉、知识截⽌、上下⽂窗⼝)
2. ⼤模型应⽤形态了解AI大模型应用形态,包含了以下技术点:
API调⽤模式| 聊天对话模式| 智能体Agent模式| RAG知识库问答模式| 多模态应⽤模式(⽂⽣图、图⽣⽂、⽂⽣视频)
3. ⾏业落地场景概览了解AI大模型行业落地场景,包含了以下技术点:
AI客服、AI教育、AI医疗、AI办公、AI营销、AI编程等典型案例| 从场景到产品的转化逻辑
4. Coze智能体开发掌握Coze智能体开发,包含了以下技术点:
Coze平台定位(⼀站式AI智能体开发平台)| Coze国内版vs国际版| 平台核⼼能⼒:Bot创建、知识库、插件、⼯作流、发布多端
5. 对话式智能体搭建该部分主要学习对话式智能体搭建,包含以下技术点:
⻆⾊扮演提示词编写技巧| 设定⻆⾊身份、语⽓⻛格、知识边界| 对话开场⽩设计| 提示词调试与迭代优化| 上下⽂窗⼝概念| 多轮对话记忆机制| 对话变量设置| 上下⽂⻓度管理策略| 发布到⾖包| 发布到⻜书| 发布为API接⼝| 发布为独⽴⽹⻚链接| 微信/钉钉等渠道集成
6. 知识库与RAG应⽤该部分主要学习知识库与RAG应⽤,包含以下技术点:
RAG(检索增强⽣成)原理| 知识库能解决的问题(突破知识截⽌限制、企业私有知识问答、降低幻觉)| 知识库搭建与配置| Bot绑定知识库
7. 插件与⼯具能⼒该部分主要学习插件与⼯具能⼒,包含以下技术点:
什么是插件| Coze插件商店| 内置官⽅插件(搜索、图⽚识别、链接读取等)| 第三⽅插件| 链接读取插件、搜索插件、代码执⾏插件、图⽚理解插件、代码执⾏插件与图⽚理解插件实战
8. ⼯作流WorkFlow该部分主要学习⼯作流WorkFlow,包含以下技术点:
什么是⼯作流| ⼯作流vs简单对话Bot的适⽤场景| 可视化编排节点介绍| 开始节点(输⼊定义)| 结束节点(输出设置)| ⼤模型节点(LLM调⽤)| 代码节点(Python/JS)| 条件判断节点| 变量聚合节点| 节点编排实操
9. Coze智能体项⽬该部分主要学习Coze智能体项⽬,包含以下技术点:
智能体项⽬需求分析| Bot架构设计| 分模块开发| 联调测试| 最终发布上线| 多端适配验证| ⽤户反馈收集| 后续迭代计划
10. VibeCoding理念与准备该部分主要学习VibeCoding理念与准备,包含以下技术点:
Vibe Coding是什么| AI编程⼯具链| Claude Code安装与配置
11. Vibe Coding零代码开发智慧医疗智能体该部分主要学习Vibe Coding零代码开发智慧医疗智能体,包含以下技术点:
医疗问诊智能体项⽬定位| 需求分析| 技术架构与项⽬数据流转| 项⽬结构搭建| ⼤模型接⼊| 问诊业务逻辑| 知识库服务| ⽇志与监控| 异常处理体系| 前端交互开发| 基于Vue打造前端Web界⾯| 前后端联调| 功能测试| 安全测试| 体验测试| 部署⽅案选型| 项⽬总结与展示
12. Coze智能体与Vibe Coding项⽬实战该部分主要学习Coze智能体与Vibe Coding项⽬实战,包含以下技术点:
⼩组分配| 任务说明| 任务划分| ⼩组基于Coze开发智能体| 搭建WEB⻚⾯| Vibe Coding零代码开发⼩游戏| 项⽬答辩
13. ⼤模型必备Python基础掌握大模型必备Python基础语法,包含了以下技术点:
学习⼤模型必备Python语⾔| Python解释器和Pycharm开发⼯具安装| 注释和变量| 标识符和关键字以及命名规范| 输⼊和输出函数| 算数运算,⽐较运算,逻辑运算,赋值运算
14. ⼤模型必备Python流程语句掌握大模型必备Python流程语句,包含了以下技术点:
Python的三⼤流程控制语句| if选择结构,while/for循环结构| pass占位语句| 循环嵌套中的break/continue| 双重for循环执⾏流程| 99乘法表案例| 图形打印案例(三⻆形、菱形等)| 循环嵌套性能注意事项| 猜数字游戏开发、⽤户登录验证、带menu菜单程序设计实战
课时:10天 技术点:80项 测验:1次 学习方式:线下面授
掌握面向对象编程思想| 独立运用面向对象思想完成指定需求| 掌握深拷贝和浅拷贝代码原理| 独立完成面向对象版-学生管理系统| 掌握闭包, 装饰器的用法| 独立完成网编案例代码实现| 掌握多进程, 多线程相关代码实现| 掌握上下文管理器对象的使用| 掌握生成器, 迭代器的用法| 理解正则表达式的相关运用| 掌握MySQL基本操作| 掌握Pandas基本操作
1. ⼤模型必备Python容器掌握大模型必备Python容器,包含了以下技术点:
容器的概念与⽤途| Python内置容器类型:str/list/tuple/set/dict| 可变容器 vs 不可变容器| 容器选择决策| 索引与切⽚操作
2. ⼤模型必备Python函数掌握大模型必备Python函数,包含了以下技术点:
函数⼊⻔| 函数定义和调⽤| 函数的参数和返回值| 变量作⽤域| 函数的多种参数| 拆包和变量交换| Lambda表达式
3. ⼤模型必备Python⽂件和异常处理掌握大模型必备Python文件和异常处理,包含了以下技术点:
⽂件的读写⼊⻔| 中⽂乱码和路径问题| ⽂件复制| os模块| with-open语法| 异常处理⽅式| 导⼊包和模块
4. ⾯向对象从逐步建立起面向对象编程思想,再到会使用对象,到创建对象,再到真正理解为什么封装对象。包含了以下技术点:
⾯向对象和⾯向过程| 类和对象的区别| 定义类和属性| 定义⽅法和魔法⽅法| ⾯向对象-案例| 【实战案例】⾯向对象综合实战案例| 继承的使⽤| 私有权限| 类属性和对象属性| 类⽅法和静态⽅法| ⾯向对象版-学⽣管理系统| 【实战作业】⾯向对象版-学⽣管理系统(采取部分实战)
5. Python⾼阶语法主要学习Python高阶语法,包含了以下技术点:
深拷⻉, 浅拷⻉详解| 闭包详解| 装饰器详解| 【实战案例】装饰器实战案例| ⽹编相关概述介绍| ⽹编案例-客户端发送⽂件到服务器端| 并⾏和并发详解| 多进程-代码实现| 【实战案例】⽹编案例-客户端和服务器端交互| 多线程代码实现| 守护线程详解| 互斥锁详解| 线程同步详解| 上下⽂管理器详解| Json数据⽂件读取和处理| 【实战案例】Json数据⽂件读取和处理| ⽣成器详解| 协程详解| 迭代器详解| 正则表达式详解| 【实战案例】正则表达式⽂本匹配综合案例
6. SQL数据库主要学习MySQL数据库的核心知识,包含了以下技术点:
数据库基本操作| 数据库概念和作⽤| 关系型数据库和⾮关系型数据库| MySQL数据类型| 数据完整性和约束| 数据库创建| 表操作命令| 表数据操作命令| where⼦句| 分组聚合| 连接查询| 外键的使⽤| PyMySQL安装和使⽤| sql注⼊| 【实战案例】 ⽤户登录系统| Redis安装| 字符串 (String) 缓存| 哈希 (Hash)存储对象| 列表 (List)消息队列| 有序集合 (ZSet)排⾏榜等
7. Pandas主要学习Pandas核心知识,包含以下技术点:
Numpy基础概念与操作| 运算优势| 数组的属性| 数组的索引| 数组的形状| 数组的运算| 数组的⼴播机制等| Pandas统计分析| Pandas数据整理| Pandas透视表| Pandas+Matplotlib可视化(直⽅图/散点图/柱状图/折线图/饼图)| 【实战案例】中美⽇GDP数据折线图制作
课时:2天技术点:20项测验:1次学习方式:线下面授
能够理解和应⽤提示词⼯程原理| 掌握优化技巧并完成⾦融业务场景的实际问题解决
基于Zero-shot零样本学习能⼒,通过DeepSeek/QWen/ChatGLM模型对⾦融领域数据进⾏分类、信息抽取、⽂本匹配,更好的解决业务问题
提示词撰写解决方案| 文本分类提示词解决方案| 信息抽取提示词解决方案| 文本匹配提示词解决方案
⼤模型发展过程| 提示词介绍及撰写介绍| 提示词优化⽅法| 基于Ollama模型部署完成提示词⼯程案例| 什么是Prompt Engineering| Prompt Engineering的原理以及实际应用的优化技巧| 如何利用Prompt Engineering完成实际金融业务
课时:6天学习方式:线下面授
基于Coze的智能⾯试助⼿项⽬(⾯试通)
基于Dify的电商智能分析项⽬(数智通)
基于Coze⼯作流平台,结合LLM、ASR、TTS、RAG等技术,为⿊⻢程序员AI学科学⽣构建⾯试全流程智能辅助系统,实现简历修改、⾯试录⾳分析、个性化⾯试题⽣成和实时语⾳模拟⾯试等功能
能够掌握Coze智能体开发范式 | 能够独⽴完成多场景智能体应⽤的构建与部署 | 能够实现⼯作流⾃动化与业务赋能
实现基于插件完成PDF、DOCX等⽂档转⽂本到分析处理的全流程解决⽅案 | 实现基于ASR技术实现录⾳⽂件转⽂本到分析处理的全流程解决⽅案 | 实现基于知识库结合PDF实现精准内容⽣成的解决⽅案 | 实现在⼯作流中读写数据库和知识库的解决⽅案 | 实现⽗⼦模式多Agent架构⾃主规划执⾏解决⽅案
简历修改:基于OCR插件、prompt、数据库查询,实现简历中各类常⻅问题的召回和修改建议,以及进阶功能:违禁词过滤、业务背景重复率统计等,辅助学⽣编写更好的简历 | ⾯试录⾳分析:基于多模态⼤模型实现ASR,基于prompt实现⾯试官、应试者⻆⾊划分,最终实现⽂字提取、摘要以及建议,提⾯试⾼录⾳分析的效率 | ⾯试题⽣成:基于⿊⻢⾯试宝典使⽤RAG技术结合学⽣的简历,结合简历上的技能点、业务背景、毕业时间、专业等信息,⽣成个性化的⾯试题题库 | 模拟⾯试:基于简历和⾯试题⽣成流⽔线等功能,基于邢⽼师⾳⾊克隆⾯试官⾳⾊,结合ASR模型、TTS模型等技术,实现实时语⾳⾯试
本项⽬针对电商业务中数据分散(数据库)、规则分散(⽂档)、系统割裂(BI/知识库/AI⼯具)以及业务⼈员不会SQL、不会分析数据等痛点,基于Dify构建⼀套电商AI智能分析系统,通过融合⼤模型(LLM)、RAG检索和数据库分析能⼒,实现“⾃然语⾔提问 → ⾃动查询数据/知识 → 智能分析 → 图表展示”的⼀体化闭环,显著降低数据分析⻔槛,提⾼数据利⽤效率和业务决策能⼒
理解AI数据分析系统从“模型调⽤”到“系统设计”的完整流程 | 掌握Dify平台核⼼能⼒(RAG/Agent/Workflow)及应⽤开发掌握⾃然语⾔转SQL的数据分析实现⽅案 | 掌握RAG知识库构建流程(分段/Embedding/检索/⽣成)掌握多节点⼯作流编排(判断/分⽀/循环/组合) | 掌握数据分析结果⾃动解释与可视化实现 | 具备AI系统整合能⼒(数据库 + 知识库 + ⼤模型 + ⼯作流)
数据查询问题:通过LLM⾃动⽣成SQL,实现“不会SQL也能查数据” | 知识分散问题:构建RAG知识库,实现统⼀语义检索与问答 | 系统割裂问题:通过Dify⼯作流整合数据分析、知识问答与AI能⼒ | 分析能⼒不⾜问题:LLM⾃动对查询结果进⾏总结与解释 | 可视化困难问题:⾃动⽣成图表(趋势/对⽐/占⽐)辅助决策 | 复杂任务不稳定问题:通过Workflow拆解任务,提⾼系统可控性与稳定性 | 整体⽅案:构建“查询 + 检索 + 分析 + 可视化”的AI闭环系统
Dify平台:模型管理、⼯作流编排、应⽤发布 | Prompt⼯程:提示词设计、约束控制、结构化输出(JSON) | RAG技术:⽂档分段、Embedding、向量检索、混合检索、重排 | 数据库与SQL:MySQL结构设计、⾃然语⾔转SQL、查询优化 | ⼯作流设计:多节点流程、分⽀判断、循环控制、代码节点 | ⼤模型应⽤:LLM问答、数据分析解释、结果⽣成 | 数据可视化:ECharts图表⽣成(折线图/柱状图/饼图) | 系统⼯程:AI应⽤架构设计、多模块集成、业务落地能⼒
课时:13天 技术点:100项 测验:1次 学习方式:线下面授
掌握AI/ML/DL基本概念及数据、算法、算力协同| 能处理数据(特征标签划分、归一化标准化)、诊断欠/过拟合、用交叉验证和网格搜索调参| 熟悉KNN、线性回归、决策树、Bagging与Boosting、随机森林、聚类及评估| 具备PyTorch实操:张量与自动微分、搭建全连接网络(激活函数、损失函数、优化器、正则化)、设计CNN(卷积池化步长填充)做图像分类、用RNN处理文本(词嵌入、文本生成)| 理解词向量与Transformer(自注意力、位置编码),会用BERT做文本分类、相似度等下游任务| 了解常见BERT变体| 能独立完成预训练模型微调| 具备NLP应用搭建能力
1. 机器学习概述该部分主要学习机器学习基础,包含以下技术点:
⼈⼯智能(AI)| 机器学习(ML)| 深度学习(DL)| 三者关系| 基于规则的学习与基于模型的学习的区别| 数据| 算法| 算⼒| CPU、GPU、TPU的特点| 样本| 特征| 标签| 训练集| 测试集| 有监督学习(回归/分类)| ⽆监督学习(聚类)| 半监督学习| 强化学习
2. 机器学习的主要步骤该部分主要学习机器学习的主要步骤,包含以下技术点:
获取数据| 数据基本处理| 特征⼯程| 模型训练| 模型评估| 上线服务| 特征提取| 特征预处理| 特征降维| 特征组合| ⽋拟合、过拟合的概念及产⽣原因| 泛化能⼒与奥卡姆剃⼑原则| KNN算法的核⼼思想| 交叉验证与⽹格搜索(GridSearchCV)| 混淆矩阵、精确率、召回率、F1-score
3. 经典机器学习算法该部分主要学习经典机器学习算法,包含以下技术点:
线性回归模型|损失函数(MSE)| 正规⽅程法与梯度下降法(全梯度/随机梯度/⼩批量梯度/SAG)| 评价指标:MAE、MSE、RMSE| L1正则化(Lasso回归)| L2正则化(岭回归)| 决策树(CART)的分类与回归原理| 决策树剪枝(预剪枝/后剪枝)| 集成学习思想| Bagging(随机森林)| Boosting(AdaBoost/GBDT/XGBoost等)| 随机森林的构建⽅法| 聚类算法(⽆监督学习)概念| 常⽤⽅法(K-Means/层次聚类/DBSCAN等)| K-Means算法实现流程| 聚类评估——SSE(误差平⽅和)、肘⽅法
4. 深度学习架构该部分主要学习深度学习架构,包含以下技术点:
深度学习概念| 深度学习发展史| 与机器学习的关系| 神经⽹络结构| 神经元构成| 输⼊层| 隐藏层| 输出层| 参数初始化⽅法| 激活函数| Sigmoid| tanh| ReLU| SoftMax
5. 神经⽹络优化⽅法该部分主要学习神经⽹络优化⽅法,包含以下技术点:
损失函数| 交叉熵| MAE| MSE| smoothL1| 优化算法| SGD(随机梯度下降)| Momentum(动量)| Adam(⾃适应矩估计)| 学习率衰减与正则化| 学习率衰减| Dropout(随机失活)| BN(批归⼀化)
6. 经典⽹络架构该部分主要学习经典⽹络架构,包含以下技术点:
卷积神经⽹络| 卷积层| 池化层| 特征图计算| 完成CIFAR-10图像分类| 循环神经⽹络| 词嵌⼊| RNN原理| 周杰伦歌词⽣成任
7. Pytorch框架该部分主要学习Pytorch框架,包含以下技术点:
Pytorch安装与环境配置| 张量的概念| 张量的创建| 类型转换| 数值计算| 索引操作| 形状变换| 张量的拼接| ⾃动微分| Pytorch构建神经⽹络| Pytorch案例实战
8. NLP⼊⻔该部分主要学习NLP⼊⻔核心技术,包含以下技术点:
什么是⾃然语⾔处理NLP| ⾃然语⾔处理NLP的发展史| ⾃然语⾔处理应⽤场景| 什么是⽂本预处理| ⽂本处理的基本⽅法| ⽂本张量的表示⽅法| ⽂本数据分析| ⽂本特征处理
9. RNN及其变体该部分主要学习RNN及其变体,包含以下技术点:
什么是RNN| RNN模型作⽤及类别| 传统RNN| LSTM| GRU
10. Transformer该部分主要学习Transformer,包含以下技术点:
什么是transformer| transformer的作⽤| transformer模型架构| transformer优势
11. 迁移学习该部分主要学习迁移学习,包含以下技术点:
Fasttext| 迁移学习| NLP中常⽤预训练模型| Transformers库的使⽤
课时:7天技术点:100项测验:1次学习方式:线下面授
基于⼤规模业务留存数据构建快速⽂本分类系统| 快速搭建短⽂本精准分类模型| 基于随机森林和FastText搭建快速基线模型, 验证业务通道的能⼒基于BERT的迁移学习优化模型搭建的能⼒| 实现神经⽹络量化的优化与测试| 实现神经⽹络剪枝的优化与测试| 实现神经⽹络知识蒸馏的优化与测试| 更多主流预训练模型的优化与深度模型剖析| BERT模型在⽣成式任务和⼯程优化上的深⼊扩展
NewsCompass投满分项⽬是结合今⽇头条真实场景下的海量数据, 快速搭建随机森林和FastText的基线模型, 以验证商业化落地的可⾏性. 更多聚焦在深度学习的优化⽅法上, 搭建基于BERT的初版微调模型, 应⽤量化,剪枝,预训练模型微调,知识蒸馏等多种⼿段,反复迭代,反复优化模型的离线效果,在线效果
海量⽂本快速分类基线模型解决| ⽅案基于预训练模型优化的解决⽅案| 模型量化优化的解决⽅案| 模型剪枝优化的解决⽅案| 模型知识蒸馏优化的解决⽅案| 主流迁移学习模型微调优化的解决⽅案
随机森林(集成学习)| 基线模型(FastText)| BERT优化| 模型量化、剪枝、知识蒸馏| 基于大模型文本分类
课时:1天 技术点:50项 测验:1次 学习方式:线下面授
理解LangChain框架的定位和基本概念| 掌握LangChain框架models、chain、prompt、indexes| 掌握LangChain框架记忆的使⽤
1. ⼤模型模型层Models该部分主要学习⼤模型模型层Models,包含以下技术点:
LLM 基类:输⼊⽂本输出⽂本,传统⼤模型调⽤接⼝封装| ChatModel聊天模型:消息结构(System/Human/AI Message),对话格式封装| 模型集成:OpenAI、通义千问、本地开源模型 (Ollama/LlamaCpp)| 模型参数配置:temperature、top_p、max_tokens、stop词、流式输出stream| Embedding接⼝:⽂本向量化,⽂档Embedding、查询Embedding区别| 开源/闭源 Embedding 模型接⼊| 批量⽂本嵌⼊、⽂本分⽚后向量化| 向量维度、相似度计算(余弦相似度)
2. 提示词⼯程层Prompts该部分主要学习提示词⼯程层Prompts,包含以下技术点:
基础 PromptTemplate:变量占位符`{变量}`,字符串模板渲染| ChatPromptTemplate:多⻆⾊消息模板组合 (System/Human/AI)| Partial 局部变量预填充| from_messages 快速构建聊天模板| FewShotPromptTemplate 少样本模板| Example 样本示例| BaseOutputParser 基类,解析⼤模型返回⽂本| PydanticOutputParser:结构化输出 JSON,绑定数据模型| JsonOutputParser、CommaSeparatedListOutputParser| 格式化提示词注⼊,告诉模型输出格式
3. ⼯具与智能代理Agents (⾃主调⽤⼯具)该部分主要学习⼯具与智能代理Agents,包含以下技术点:
BaseTool ⼯具基类:name、description、_run 执⾏逻辑| 内置⼯具:搜索⼯具、计算器、PythonREPL 代码执⾏| ⾃定义⼯具 @tool 装饰器快速定义| Agent核⼼逻辑:思考(Thought)→⾏动(Action)→观察(Observation) ReAct框架| ReAct Agent、OpenAI Function Calling Agent| AgentExecutor代理执⾏器,循环执⾏思考调⽤⼯具| ⼯具选择、⼯具错误处理
课时:8天学习方式:线下面授
基于职业教育领域RAG智慧问答系统项目
基于人力资源场景的RAG简历推荐系统项目
企业级标准RAG解决⽅案。基于IT职业教育⾏业答疑⼤模型抽取RAG解决⽅案,通过项⽬学习完成企业级RAG系统完整流程搭建与测试及优化。从智能查询路由设计、数据处理与多源集成、模型微调到后端服务与前端开发以及Docker企业级部署,完成全栈RAG系统构建
了解LangChain基本概念、明确LangChain主要组件的作⽤、了解LangChain常⻅的使⽤场景 | 掌握基于LangChain+ChatGLM-6B模型实现本地知识库的问答实现原理+过程| RAG系统开发与优化:掌握从数据分⽚到答案⽣成的RAG全流程,熟练应⽤ HyDE、⼦查询等检索增强策略提升系统性能 | ⼤模型应⽤实践:能够集成LLM(如 OllamaLLM)并设计⾼效Prompt,解决知识问答中的业务定制化需求 | 智能查询路由设计:实现规则、相似度和LLM三层路由,精准分发查询并优化复杂意图识别效率 | 后端服务与前端开发:使⽤FastAPI开发⾼并发API并通过Gradio构建交互界⾯,满⾜企业级服务与⽤户体验要求 | 数据处理与多源集成:熟练处理结构化与⾮结构化数据,结合MySQL和向量搜索打造⾼效知识检索系统 | 企业级问题解决能⼒:通过⽇志调试和⾼并发设计,具备定制化开发与性能优化的实战技能,适配智能客服等场景
数据库查询优化:BM25 + Redis 缓存解决方案 | 语义检索:Milvus 混合向量检索解决方案 | 查询分类:BERT 分类器解决方案 | 动态检索策略:LLM 驱动的策略选择解决方案 | 答案生成:LLM + RAG 提示模板解决方案 | 性能优化:Redis 缓存 + 模块化设计解决方案 | 日志与监控:统一日志系统(logging)解决方案 | 配置管理:ConfigParser + config.ini解决方案
智能问答系统架构:FAQ系统与RAG系统的区别与应⽤场景 | 数据库技术:MySQL表查询;Redis键值存储与缓存机制;Milvus向量数据库的架构与索引类型 | 检索算法:BM25算法原理;密集向量&稀疏向量混合检索;重排序的作⽤ | query的意图识别+改写:BERT分类器的训练与推理;LLM的调⽤与提示设计;查询分类与动态检索策略的实现逻辑 | 企业级开发实践:模块化代码设计与代码复⽤;配置⽂件(config.ini)与环境变量管理;⽇志系统设计与错误处理
项⽬基于向量数据库和LLM构建⼀个端到端、可⽔平扩展的检索增强⽣成(RAG)系统,⽀持对异构简历(PDF/DOCX/JPG/PNG)进⾏⾃动解析、结构化、语义索引与多轮对话式推荐。系统以向量数据库为核⼼存储,以LLM为推理中枢,以Agent框架为调度单元,⾯向企业HR及猎头平台提供秒级、可追溯、可解释的候选⼈推荐服务
掌握⽂档智能处理、向量化索引、RAG系统开发掌握Agent框架应⽤ | 能够完成可扩展的简历推荐系统部署
基于LangChain+OpenAI实现异构简历(PDF/DOCX/JPG/PNG)智能解析与结构化提取 | 使⽤Milvus+BGEM3混合嵌⼊+ElasticSearch实现⾼级向量索引与多路召回 | 构建⽀持参数过滤、查询重写与历史对话的异步RAG链⽣成JSON候选⼈推荐 | 基于SmartRecruitAgent框架实现意图识别、多轮追问与上下⽂候选⼈筛选的智能代理集成Streamlit前端与Milvus/MongoDB/Elasticsearch多数据库持久化的DevOps配置 | 使⽤Ragas框架对RAG系统进⾏端到端Faithfulness/Answer Relevancy/Context Precision评估优化
配置管理与项⽬初始化:使⽤Pydantic统⼀管理系统参数(数据库、模型路径、切块参数等),避免硬编码,确保全局配置安全可验证 | ⽂档处理与切块:实现多格式简历加载、⽂件哈希去重、LLM结构化信息提取(姓名、性别、年龄、⼯作年限)以及⽗块-⼦块分层切分,⽀持图⽚OCR提取|向量存储与混合检索:基于Milvus(稠密+稀疏向量)+Elasticsearch(BM25全⽂搜索+MongoDB(元数据存储),结合CrossEncoder重排序和doc_hash去重,实现⾼效混合检索与过滤 | RAG链构建与⽣成:使⽤LangChain构建异步查询改写、检索上下⽂格式化与LLM⽣成链,⽀持结构化JSON推荐输出 | 智能Agent意图优化:实现意图识别、招聘参数提取、追问处理与对话历史管理,路由不同场景(招聘需求、闲聊、追问等) | Web应⽤与数据初始化:基于Streamlit开发聊天交互、简历上传、候选⼈卡⽚展示与在线查看功能,实现端到端⽤户体验
课时:1天 技术点:30项 测验:0次 学习方式:线下面授
使⽤LangGraph设计并实现具备状态管理、条件分⽀、并⾏执⾏、断点恢复的复杂AI ⼯作流| 理解并应⽤Reducer机制解决并⾏节点状态冲突问题| 区分条件边与Command的适⽤场景,并能根据需求灵活选择| 独⽴部署并配置LangFuse本地服务,为AI Agent接⼊链路追踪| 通过LangFuse控制台分析Agent执⾏过程,定位性能瓶颈、Prompt问题、检索错误或 Token消耗异常| 在团队项⽬中集成LangFuse回调,实现⽣产级可观测性,提升AI应⽤的调试与优化效率
1. LangGraph框架该部分主要学习LangGraph框架核心知识,包含以下技术点:
理解Graph(⼯作流框架)| State(状态容器,TypedDict定义)| Node (执⾏单元,函数接收State返回更新)| Edge(连接与流向,含普通边和条件边)| Checkpoint(检查点持久化)| 使⽤Annotated类型标注字段的更新策略(如add_messages⽤于消息列表追加,operator.add⽤于数值累加),解决并⾏节点并发更新同⼀字段的冲突问题| 掌握StateGraph类的使⽤,通过add_node添加节点函数, add_edge(START, node)和add_edge(node, END)定义流转, add_conditional_edges绑定路由函数与路径映射表,实现动态分⽀| 节点直接返回Command(goto="node_name") 动态指定下⼀步,⽀持并⾏执⾏多个节点(goto传⼊列表),相⽐条件边更灵活,适合复杂动态流程| 使⽤SqliteSaver(或MemorySaver)作为checkpointer,通过thread_id区分会话,invoke时传⼊config⾃动保存状态,⽀持中断后恢复执⾏| 状态聚合:多个节点更新同⼀字段时通过Reducer合并| 分⽀并⾏:⼀个节点连接多个后继节点,LangGraph⾃动并⾏执⾏| 分⽀节点数量不同的并⾏处理:通过将多个前驱节点指向同⼀后继节点(add_edge(["B2", "C"], "D"))实现等待合并| 条件并⾏:add_conditional_edges配合返回列表的路由函数,动态决定并⾏执⾏哪些节点
2. Langfuse框架该部分主要学习Langfuse框架核心知识,包含以下技术点:
Trace(⼀次完整Agent执⾏)| Span(执⾏中的每个步骤,如节点调⽤、 LLM请求)| Session(同⼀会话的多条Trace归组)、User(按学员ID过滤)| 通过Docker启动LangFuse服务(端⼝3001),⾸次使⽤需注册本地账号并⽣成API Key(Public Key+Secret Key),在.env.local中配置 LANGFUSE_PUBLIC_KEY、LANGFUSE_SECRET_KEY、LANGFUSE_HOST| 使⽤langfuse.callback.CallbackHandler创建Handler,通过LangChain的Callback机制注⼊config["callbacks"],LangGraph的ainvoke⾃动追踪每个节点的输⼊、输出、耗时、Token消耗
课时:8天学习方式:线下面授
EduAgent多智能体项⽬
星通通⽤智能体项⽬
基于LangChain、LangGraph和FastAPI构建。系统提供智能问答、代码审查、个性化学习路径规划和职业咨询等核⼼功能,旨在为在线教育场景提供全⽅位的AI辅助教学解决⽅案
基础设施:⼀键docker-compose启动全环境,PostgreSQL、Milvus、Redis、MinIO、 Judge0 全部就绪 | 公共能⼒层:LLM Factory多模型路由、BGE-Reranker精排、MiniLM意图分类,全部可独⽴调⽤ | 四⼤Agent:智能问答、试卷批改、简历审查、模拟⾯试,端到端流程完整跑通,异常处理与降级策略覆盖到位 | 前端集成:Vue3界⾯与后端API全⾯对接,SSE流式输出流畅,三级⻆⾊权限路由隔离完整 | 集成测试:核⼼流程覆盖率达标,三层兜底降级机制验证通过,并发压测⽆崩溃
教育场景多租户数据隔离解决⽅案:所有PostgreSQL表预埋tenant_id,Milvus Collection按租户namespace隔离,⽀持多班级、多课程独⽴运营 | ⾼精度RAG冷启动与持续迭代解决⽅案:初始知识库由课程资料清洗⼊库,检索链路采⽤混合召回+精排+置信度过滤,低置信度问答⾃动进⼊补充队列,教师在线添加后热更新知识库 | 复杂批改任务的三轨并⾏加速解决⽅案:试卷批改Agent中,客观题规则引擎、简答题LLM分组并⾏、代码题Judge0执⾏+LLM评估三条轨道通过asyncio.gather并发执⾏,整体批改耗时降低60%以上 | Human-in-the-Loop教师确认解决⽅案:利⽤LangGraph的interrupt()挂起批改结果,教师登录后逐题确认或修改,通过Command恢复图执⾏,并集成企业微信机器⼈⾃动推送待确认通知 | 国产模型低成本切换与降级解决⽅案:LLM Factory封装DeepSeek-V3(通⽤)和 DeepSeek-Coder-V2(代码),⽀持配置热切换;三层兜底机制(重试→降级模型→预设回复)保障LLM服务异常时的系统可⽤性 | 本地开发到⽣产环境的平滑迁移解决⽅案:本地使⽤DockerCompose + MemorySaver+MinIO,⽣产环境仅需修改配置(AsyncPostgresSaver、阿⾥云 RDS/OSS、K8s 部署),业务代码零改动,⽀持⼀键迁移
系统架构设计:理解EduAgent的五层架构(前端→API⽹关→Orchestrator→Agent执⾏层→公共能⼒层→MCP→数据存储),掌握分层职责与数据流向 | 四⼤Agent状态机实现:分别构建智能问答(RAG+多轮记忆)、试卷批改(三轨并⾏ + HitL)、简历审查(六维度并⾏)、模拟⾯试(四阶段状态机),熟练使⽤LangGraph的StateGraph、节点、边、并⾏发送(Send)等核⼼API | 意图识别与动态路由:基于MiniLM分类器+LLM 兜底实现请求分级(单Agent直达/多Agent串联/澄清对话),通过LangGraph条件边动态编排执⾏链路 | 公共能⼒层封装:实现LLM Factory(DeepSeek-V3/Coder-V2切换)、BGE-Reranker进程内精排、Milvus分层知识库检索、对话记忆(MemorySaver/AsyncPostgresSaver)等共享组件 | MCP⼯具统⼀接⼊:理解MCP协议,实现知识库检索、代码沙箱(Judge0)、数据库操作、⽂件解析、外部搜索等MCP Server,并在LangGraph Agent中通过MCP Client 标准化调⽤ | 教师端Human-in-the-Loop:使⽤LangGraph的interrupt()和Command实现试卷批改的教师确认节点,⽀持暂停、修改、恢复,并集成企业微信通知
通⽤智能体作为该领域的⾼阶形态,其开发能⼒可为各类垂直场景的智能体构建提供坚实基础与技术范式。本项⽬基于Langchain 1.0框架,集成了MCP协议、多模态处理及联⽹搜索等前沿技术,是理解和构建复杂智能体平台的实战标杆。项⽬旨在构建⼀个基于LangChain⽣态的通⽤Agent平台,实现⾃主任务规划、多模态交互及联⽹搜索功能,⽀持多⽤户并发,具备极强的扩展性
构建智能代理中枢:实现⼯具调⽤、⾃主任务规划及深度上下⽂理解 | 实现全模态覆盖:⽀持主流办公⽂档(PDF/Word/Excel/PPT)及图⽚的双向处理 | 集成实时信息检索:通过Tavily API实现联⽹搜索,确保信息的时效性与准确性 | 提供企业级架构:⽀持多⽤户、多会话,提供完善的监控与追踪能⼒
基于Langchain DeepAgents,完善⽂件管理与任务规划 | 通过⽣图模型与VLM增加图⽂能⼒ | 通过若⼲MCP扩展Agent能⼒ | 通过Skill-creator与⽂件管理增加制作Skill并⽴即⽣效的能⼒ | 通过Docker完善项⽬部署
LangChain1.0:核⼼基座,整个项⽬是⼀个Langchain1.0框架下的⼯程,提供项⽬架构,Agent基座,中间件编排,⼦Agent编排等 | LangSmith:可视化观测⽇志与调试项⽬,使Agent可在⾼效的体系下调试 | Tavily Search:联⽹搜索集成,使Agent可获取实时信息 | SiliconFlow API:多模型服务接⼊,提供了LLM、VLM及图像⽣成能⼒的统⼀接⼊,且有免费额度,因此该项⽬得以在基于免费资源开发 | MinIO:对象存储,通过对象存储,传递Agent制作的⽂件给⽤户 | Agent Chat UI:开箱即⽤的前端界⾯,与LangChain⼯程⽆缝衔接,使得Agent可以有⼀个直观的可视化界⾯ | Docker:项⽬整合与部署,整合⼯程与数据库依赖,使项⽬最终可以⼀键部署 | MCP:连接外部⼯具,连接了Excel-mcp,Tavily Search,ppt-mcp等⼯具,丰富Agent的能⼒ | PostgreSQL:关系型数据库,存储历史对话与状态信息等LangChain⽣产级⼯程指定数据库, 现有协议使得开发⾼效
课时:6天学习方式:线下面授
中医知识图谱Agent项⽬
智能旅游多Agent项⽬
SmartCloud云服务系统
“草本通” 项⽬致⼒于解决中医药知识难以理解、碎⽚化严重、检索效率低 等问题,通过爬⾍、DeepSeek+LangChain实体抽取、Neo4j图谱构建与LangGraph多智能体协同,打造⼀个可理解、可对话、可传播、可拓展的智能知识服务平台。系统融合多种AI技术,⽀持从数据采集到语义问答、图谱构建、再到内容⽣成与平台发布的完整AI闭环
掌握知识图谱构建、多智能体流程调度 | 掌握⽣成式应⽤开发 | 能够具备垂直领域知识智能化平台的搭建能⼒
多源中医药数据爬取与联合任务数据预处理适配知识图谱构建的解决⽅案 | 基于Neo4j + FAISS的中医药知识图谱检索增强(RAG)解决⽅案 | 基于LangGraph的中医药智能问答与多意图⼯作流编排解决⽅案 | 基于FastAPI实现LangGraph智能体流式API接⼝开发的解决⽅案 | 基于LlamaFactory微调⼤模型进⾏实体关系⽣成的解决⽅案
利⽤爬⾍⾃动采集中药、⽅剂、功效、症状、疾病等原始⽂本 | 使⽤⼤语⾔模型(DeepSeek)+ LangChain进⾏实体与关系抽取 | 构建Neo4j图数据库与 Faiss 向量检索双引擎,实现结构化查询与语义匹配 | 基于LangGraph搭建多智能体协同系统,管理复杂问答流程 | 提供基于Streamlit的⽹⻚端交互式问答界⾯ | ⾃动⽣成小红书⻛格图⽂内容,并实现⼀键发布,实现从“知识获取”到“内容传播”的闭环
SmartVoyage是⼀个智能旅⾏助⼿系统,使⽤A2A(Agent-to-Agent)协议构建多代理协作框架,⽀持⽤户查询天⽓和票务信息。系统包括LLM路由服务器(意图识别)、天⽓代理服务器(查询天⽓数据库)、票务代理服务器(查询票务数据库)、MCP⼯具服务器(数据库接⼝)、数据采集脚本和前端客户端。⽤户输⼊查询(如“北京天⽓”或 “北京到上海⽕⻋票”),系统通过LLM路由到合适代理,代理⽣成SQL查询MCP数据库,返回结果显示在界⾯
能够掌握A2A多代理框架开发 | 掌握意图识别与数据库查询技能 | 能够完成交互式旅⾏助⼿系统的构建
基于Python-a2a协议实现多代理A2A协作框架 | 使⽤LangChain+DeepSeek构建LLM路由服务器意图识别与动态路由 | 实现MCP⼯具服务器标准化MySQL查询接⼝ | 天⽓代理服务器LangChain SQL⽣成与MCP实时天⽓数据库查询集成 | 票务代理服务器多类型动态SQL⽣成与结果友好格式化 | 基于Streamlit开发A2A多代理实时交互前端客户端
LLM 路由服务器(意图识别) | 天⽓代理服务器(查询天⽓数据库) | 票务代理服务器(查询票务数据库) | MCP⼯具服务器(数据库接⼝) | 数据采集脚本|Streamlit前端客户端
项⽬基于LangChain、LangGraph和FastMCP等⼯业级框架,实现了5个专业AI智能体的协同⼯作系统,覆盖云服务全⽣命周期⽀持。项⽬集成了意图识别、追问检测、分布式缓存、多模态处理及A2A跨系统协作等前沿技术,是理解和构建⽣产级AI应⽤的实战标杆
AI架构设计能⼒:掌握微服务架构下的AI系统设计,解耦⼤脑(Agent)与⼿脚(Tools) | RAG系统构建能⼒:精通Milvus+Elasticsearch混合检索架构,实现⾼精度知识问答Agent | 编排能⼒: 熟练使⽤LangGraph构建ReAct、Saga等复杂Agent模式 | 协议集成能⼒:掌握MCP(Anthropic)和A2A(Google)两⼤前沿协议,实现⼯具标准化与跨系统协作 | 意图识别优化能⼒:实现"规则引擎+⼩模型+⼤模型"的分级意图识别,平衡成本与体验 | 分布式事务处理能⼒: 在Agent系统中落地Saga模式,保障数据⼀致性 | 全链路监控能⼒:使⽤Phoenix和LangSmith进⾏LLM应⽤的调试、评测与监控 | 多模态应⽤开发能⼒:集成⽂⽣图、⽂⽣⽂⼯作流,打造全能型助⼿ | 全栈开发能⼒:独⽴完成从后端API到前端React交互的完整开发
基于Multi-Agent协作与Agentic RAG技术构建⼯业级云服务智能客服系统的解决⽅案 | 实现MCP+A2A协议的多智能体A2A协作框架的解决⽅案 | 使⽤LangChain+LangGraph构建LLM路由服务器意图识别与动态路由的解决⽅案 | 实现基于FastMCP协议标准化MySQL查询接⼝的⼯具服务器解决⽅案 | 基于RAG+MCP调⽤实现融合知识库与业务API的上下⽂增强解决⽅案 | 实现向量数据库(Milvus+BM25(Elasticsearch)双检索的知识库增强⽣成解决⽅案 | 实现动态更新知识库的RAG服务⾃动化迭代解决⽅案 | 实现双层级智能缓存(Redis L1+会话 L2)的⾼性能响应加速解决⽅案 | ⽀持Saga分布式事务保障的多数据库(MySQL+MongoDB)对话持久化⼀致性解决⽅案 | 集成Deep Research能⼒的⾃主调研与⾏业分析报告⾃动⽣成解决⽅案 | 实现系统级别(Prometheus+Grafana+cAdvisor)与业务级别(Phoenix+ LangSmith)全链路监控的智能运维解决⽅案
Orchestrator 路由服务器(意图识别与动态路由) | Product_Tech_Agent(产品技术咨询 Agent) | Finance_Order_Agent(财务账单查询 Agent) | ICP_Service_Agent(备案与合规服务 Agent) | Deep_Research_Agent(深度研究与报告⽣成 Agent) | Ops_Marketing_Agent(营销推⼴与内容⽣成 Agent) | MCP ⼯具服务器(Base Tools / RAG Tools / Dify Tools) | Agentic RAG服务(混合检索与知识增强) | A2A协议通信层(跨 Agent 协作) | 三级智能缓存与Saga分布式事务层 | 全链路监控与可观测性层(Phoenix + LangSmith + Grafana)
课时:6天学习方式:线下面授
从Vibe Coding到SDD规范驱动交付
HeiMaClaw系统级Agent
Hermes⾼阶实战
本课程以Claude Code+Trae+OpenClaw为核⼼⼯具链,系统构建从Vibe Coding到Agentic Engineering的⽣产级AI开发体系。学员通过standardsv2.0企业级⼯程化框架,完成两⼤真实业务项⽬:基于阿⾥云天池真实数据集的⾦融营销预测系统(端到端MLOps全流程);浏览器端⾼性能⽹⻚三消游戏(实时交互引擎)。全程落地GitHub Actions+Docker⽣产级CI/CD流⽔线,实现从意图定义到Multi-Agent协同开发、再到⾃动化安全交付的完整⼯业闭环
掌握Agentic Engineering⽅法论,成为智能体全栈Owner | 熟练使⽤Claude Code + Trae实现多智能体协同开发 | 精通standards v2.0框架,快速完成企业级项⽬⼯程化治理 | 完成⾦融场景端到端MLOps全流程(数据探索→模型训练→FastAPI⽣产部署) | 掌握浏览器端⾼性能实时交互系统开发能⼒ | 独⽴搭建GitHub Actions + Docker⽣产级CI/CD与容器化交付流⽔线 | 完成OpenClaw私有化多渠道Agent平台构建与⻜书集成
基于Claude Code + Trae的Agentic Engineering多智能体协同开发解决⽅案 | 基于standards v2.0框架的企业级AI项⽬⼯程化治理与⾃动化交付解决⽅案 | 基于Claude Code Agentic开发的⾦融营销预测端到端MLOps全流程解决⽅案 | 基于GitHub Actions + Docker的⽣产级CI/CD与容器化DevOps交付解决⽅案 | 基于OpenClaw的私有化多渠道Agent平台构建与⻜书集成解决⽅案
编程抽象演进与AI编程范式(Vibe Coding → Agentic Engineering) | AI编程工具链与Agent协同策略(Cursor、Claude Code、Trae、OpenClaw) | Agentic Engineering与多智能体协同开发 | 企业级AI项目工程化规范体系(standards v2.0框架) | 数据智能分析与机器学习全流程案例实战(银行营销预测系统) | 交互式Web前端与复杂游戏逻辑实现案例实战(网页三消乐) | 生产级CI/CD与容器化DevOps交付体系(GitHub Actions + Docker多阶段构建 + Secrets安全远程部署) | OpenClaw多渠道Agent平台实战
OpenClaw项⽬是真正的⽣产级开源AI Agent⽹关,远超“聊天机器⼈壳⼦”,其核⼼竞争⼒在于完整实现了Agent记忆能⼒(Memory+RAG)、系统物理交互(Sandbox Tools)、⾃迭代防死循环(tool-loop-detection+compaction)以及Multi-Agent协同(Subagent spawn) 项⽬采⽤Monorepo(pnpm-workspace)结构,TypeScript开发,内置Pi-embedded-runner原⼦执⾏引擎,⽀持Feishu、Slack、WhatsApp等⼗余个渠道⽆缝接⼊。通过LanceDB本地向量库+混合检索+时间衰减算法,实现真正可⽤的⻓期记忆;所有Tool执⾏均在Docker/Podman沙箱中完成,具备⽂件、⽹络、资源严格隔离;⽀持动态Subagent孵化,让复杂任务⾃动拆解;集成MCP协议实现标准化⼯具调⽤;⽣产部署⽀持systemd⾃启、Nginx⾼可⽤、Prometheus监控等企业级特性 该项⽬是理解和构建真实可⽤、⻓期运⾏、⽣产级AI Agent系统的实战标杆,特别适合希望掌握从消息接⼊到Agent 执⾏全链路、从开发到运维闭环的开发者
OpenClaw架构机制理解能⼒:理解OpenClaw整体架构机制,以及Gateway、Routing、 Agents执⾏、Memory RAG、Sandbox、Subagent等核⼼模块的协同⼯作原理 | ⻜书机器⼈配置与使⽤能⼒:熟练通过命令和配置⽂件快速接⼊并配置Feishu机器⼈,实现消息标准化接⼊与实际业务交互 | Skill查询安装与⾃定义扩展能⼒:学会通过ClawHub查询安装Skill,同时掌握⾃定义创建 Skill 包(SKILL.md+tools/+prompts/)扩展Agent能⼒
通过OpenClaw⼀键部署多消息渠道标准化接⼊并统⼀管理AI Agent的解决⽅案 | 通过OpenClaw ClawHub技能市场⼀键安装扩展Agent能⼒的解决⽅案 | 通过OpenClaw⾃定义创建并部署专属Skill包(SKILL.md+tools/+prompts/)扩展 Agent能⼒的解决⽅案 | 通过OpenClaw Sandbox安全执⾏Tool并彻底保障系统与数据安全的解决⽅案
Gateway 接收层(WebSocket + HTTP 统⼀⼊⼝与 Event Bus) | Multi-Channel 消息插件层(Feishu / Slack / WhatsApp / Discord 等适配器) | Routing 路由层(resolve-route.ts + 多租户 Session 隔离) | Agents 执⾏核⼼层(Pi-embedded-runner + Subagent 注册与孵化) | Memory ⻓期记忆与 RAG 增强层(LanceDB + hybrid 混合检索) | Context Engine 上下⽂引擎(静态 Workspace + 动态 Session + RAG 融合) | Hooks 扩展钩⼦系统(前置/后置消息处理) | Skills 插件化技能系统(ClawHub 市场 + SKILL.md 动态加载) | Sandbox 安全沙箱执⾏层(Podman/Docker 隔离)
HeiMaClaw×智新电池⼯⼚是⼀套⾯向制造业⼀线⽣产管理的企业级AI Agent落地⽅案。系统以HeiMaClaw⽣产级AI Agent平台为⼤脑,承担渠道接⼊、租户权限、Agent 编排、记忆审计和沙箱执⾏;以智新电池⼯⼚MCP Server为业务数据源,通过 FastMCP暴露产线状态、⼯单进度、班次产量三类业务⼯具,背后由独⽴数据库承载真实⽣产数据。两边通过MCP协议桥接,把远端⼯具统⼀注册为平台ToolRegistry中的标准⼯具,让班组⻓/⽣产主管在⻜书⾥⽤⾃然语⾔完成产线状态、⼯单进度、班次产量等真实业务查询,打通「⾃然语⾔⼊⼝→Agent 编排→MCP ⼯具→业务数据库→智能总结回复」的完整落地链路
掌握以HeiMaClaw为底座、以MCP业务服务器为数据源的「企业级Agent+业务系统」⼀体化落地能⼒ | 实现MCP⼯具的安全接⼊与⾃动注册 | 掌握MCP Server注册、 Agent可⻅性控制与权限策略联动 | 理解平台六层架构下业务数据「不进⼊平台、只⾛ MCP Tool」的设计边界 | 能够独⽴完成业务MCP Server构建、平台对接、⻜书⾃然语⾔⼊⼝验证,并基于审计、⻛险等级、租户作⽤域设计企业级安全闭环
基于FastMCP实现智新电池⼯⼚业务MCP Server并标准化暴露产线状态、⼯单进度、班次产量三类⼯具的解决⽅案 | 基于HeiMaClaw平台MCP可选依赖与桥接层实现远端⼯具⾃动安全注册到 ToolRegistry的解决⽅案 | 基于CLI命令完成MCP Server注册、Agent级可⻅性收敛及tools.allowed⽩名单联动的解决⽅案 | 基于AgentRunner + UnifiedExecutionEngine + Planner与LLM完成⾃然语⾔意图识别与槽位填充的解决⽅案 | 结合tool_gate与AuthPolicyManager实现租户隔离、权限策略下沉及企业级安全闭环的解决⽅案 | 构建“⻜书⾃然语⾔提问→HeiMaClaw Agent编排→安全MCP⼯具调⽤→业务数据库→智能总结回复”的企业级Agent+业务系统⼀体化落地闭环解决⽅案
业务MCP Server冷启动阶段,基于FastMCP框架实现电池⼯⼚业务⼯具开发,使⽤ SQLite承载产线、⼯单、班次三类真实⽣产数据,并通过SSE协议对外暴露标准业务⼯具 | HeiMaClaw平台接⼊阶段,安装MCP可选依赖,通过CLI命令完成业务服务器注册,并配置企业级元数据(传输⽅式、⻛险等级、租户作⽤域、超时等),再校验远端⼯具列表可达 | 实现MCP⼯具到ToolRegistry的安全桥接,通过桥接层⾃动拉取远端⼯具列表,采⽤安全命名规则⽣成本地⼯具名,并封装调⽤逻辑、归⼀化返回结果,同时携带权限元数据下沉到⼯具级别 | 实现意图识别与槽位填充,通过CLI把MCP Server启⽤到⽬标Agent,⾃动追加⼯具到⽩名单;运⾏时由Agent编排引擎把⾃然语⾔解析为标准⼯具调⽤,⼯具返回数据后再由LLM总结为业务话术 | 实现租户与权限闭环,每次⼯具调⽤携带租户、⽤户、⻆⾊等上下⽂,由权限策略管理器完成租户隔离与响应策略;⽀持全局开关与Agent级⼯具可⻅性动态收敛 | 实现⻜书渠道与⽣产部署闭环,完成⻜书⻓连接与回调接⼊,通过多进程启动⽅式,完成⽣产环境或智能体应⽤
课时:4天 技术点:70项 测验:1次 学习方式:线下面授
能够理解Transformer的注意⼒机制与架构设计,并掌握基于Transformer的翻译任务开发技能| 能够使⽤Hugging Face库对预训练模型进⾏全量微调,完成特定NLP任务| 能够理解主流⼤模型的架构特性与预训练原理,掌握为微调任务选择合适模型的能⼒
1. 大模型Transformer架构该模块主要学习大模型Transformer架构,包含以下技术点:
词向量(Word Embedding)| ⼤模型Transformer架构的注意⼒机制| ⼤模型Transformer架构(encoder、decoder、encoder+decoder)| ⼤模型Transformer翻译任务实战
2. 大模型迁移学习该部分主要学习大模型迁移学习,包含以下技术点:
迁移学习的预训练模型和微调阶段| NLP中的常⽤预训练模型(BERT/ GPT-1/GPT-2)| Hugging Face预训练模型仓库| Huggingface Transformers库使⽤(提供了NLP领域预训练语⾔模型结构模型和调⽤框架)| 基于微调⽅式实现中⽂分类、中⽂填空、句⼦关系等任务
3. 大模型主流模型运行机制该部分主要学习大模型主流模型运行机制,包含以下技术点:
GPT/DeepSeek/QWen基础| GPT/DeepSeek/QWen架构变化| GPT/DeepSeek/QWen的预训练任务| 基于DeepSeek/QWen预训练+微调任务实战
课时:4天技术点:80项测验:0次学习方式:线下面授
了解和掌握⼤语⾔模型的基本原理和架构,特别是ChatGLM-6B模型的结构和⼯作机制| 掌握⼤模型LoRA微调技术,通过微调预训练的⼤模型来适应特定任务的需求| 掌握⼤模型P-Tuning微调技术,对⼤模型进⾏⾼效的参数调整,增强其在特定任务上的表现| 能够掌握 QLoRA 量化微调与并⾏计算技术,完成⽂本摘要模型的⾼效训练与部署
项⽬以Qwen/DeepSeek模型为核⼼,通过LoRA和P-Tuning实现微博⽂本信息抽取+⽂本分类的多任务,通过⼀个⼤模型同时解决多种任务开发和应⽤。借助DeepSpeed框架实现训练过程的加速优化。同时采⽤了GPTQ和QLoRA技术对模型进⾏量化处理,旨在进⼀步提升模型的推理速度。最终,通过Vllm平台完成了模型的部署,实现了对⽂本中关键信息的⾃动化抽取,完成信息抽取的任务
联合任务数据预处理适配模型训练的解决⽅案| 实现ChatGLM-6B+LoRA训练的解决⽅案| 实现ChatGLM-6B+P-Tuning训练的解决| ⽅案基于Flask框架实现模型API接⼝开发的解决⽅案| ⼤模型并⾏计算解决⽅案| ⼤模型量化解决⽅案| ⼤模型部署解决⽅案| ⼤模型推理优化解决⽅案
理解信息抽取任务以及⽂本分类的业务意义及应⽤场景| 数据预处理:修改数据格式适配⼤模型训练、数据张量的转换等Qwen/DeepSeek模型解析| LoRA⽅法讲解| P-Tuning⽅法解析| 基于Qwen/DeepSeek+LoRA⽅法实现模型的训练和评估| 基于Qwen/DeepSeek+P-Tuning⽅法实现模型的训练和评估| 基于Flask框架开发API接⼝,实现模型线上应⽤| 数据集处理、模型构建、模型训练、模型预测| ⼤模型并⾏计算:deepspeed,数据并⾏、流⽔线并⾏、模型并⾏| ⼤模型量化:训练量化⽅法QLora,训练后量化⽅法GPTQ| 模型部署和推理优化框架:vLLM和oLLAMA
课时:8天学习方式:线下面授
基于亚⻢逊电商商品聚合⼤模型项⽬
⿊⻢直聘⼤模型搜索推荐项⽬
项⽬以“电商商品聚合与⽐价”为核⼼业务场景,解决电商场景中多源、异构商品数据的标准化处理、⾼精度分类与智能聚合难题
环境与⼯程搭建能⼒:熟练搭建Linux开发环境,吃透模型微调完整流程,精通PyTorch 与HuggingFace⽣态,具备⼯业级算法项⽬搭建基础能⼒ | 电商数据处理能⼒:掌握电商商品数据集制作、⼤模型少样本预标注、主动学习降本、难负样本挖掘,独⽴完成业务数据清洗与优化 | 多模态模型微调能⼒:精通商品分类、向量召回、同款聚合聚类三⼤任务,熟练运⽤对⽐学习、度量学习、LoRA⾼效微调,可独⽴微调图⽂多模态模型 | 主流算法与⼯具实战能⼒:掌握双塔/交叉编码器架构、FAISS向量检索、⾃动超参调优,能⽤LlamaFactory实战微调视觉⼤模型,⾃定义训练逻辑与评估指标 | 模型推理部署落地能⼒:掌握模型量化、推理加速、注意⼒优化,可快速搭建交互式演示项⽬,完成多模态⼤模型从训练、调优到线上部署全流程落地
低成本⾼质量数据集构建解决⽅案 | 使⽤Optuna进⾏⾃动超参数寻优解决⽅案 | 多模态⼤模型微调解决⽅案 | 多模态⼤模型推理部署解决⽅案 | 多模态⼤模型推理优化解决⽅案
数据为中⼼的机器学习,包括基于Krippendorff's alpha的标注质量检测、主动学习和使⽤(推理)⼤模型的Incontext Learning(zero-shot/few-shot Learing)进⾏数据与标注,解决被学术界忽略但⼯业落地最棘⼿的数据问题 | Huggingface⽣态的深⼊学习,包括⾃定义Dataset/DataCollator、Metric | ⾃定义PretrainedConfig和PreTrainedModel | ⾃定义Trainer来实现复杂的指标计算 | 深⼊介绍checkpoint保存机制 | 使⽤Optuna来进⾏超参数搜索,⽐常⽤的GridSearch更快,⽐RandomSearch更好,同时深⼊探讨⼿动模型调参和主动调参的适⽤场景 | 介绍双塔召回模型+交叉精排模型的⼯业级架构,解决两两对⽐复杂度O(n^2)计算爆炸的问题 | 详细介绍度量学习和对⽐学习,包括arcface和InfoNCE-等损失函数以及CLIP和SigLiP等多模态模型 | 同时介绍IVF和HNSW等ANN算法原理和在FAISS的⽤法使⽤多种⽅法实现多模态的融合 | 并且介绍召回模型微调的实⽤技巧:难负样本挖掘、数据对称性处理 | 介绍多模态⼤模型微调的显存优化技巧,详细介绍LoRA,包括RS-LoRA、 AdaLoRA、pissa_init和DoRA等改进 | 同时介绍GaLore和BAdam等内存⾼效的全参数微调算法以及梯度累积、FlashAttention、混合精度训练和8-bit/4-bit 量化优化器等节省显存的训练技巧 | 深⼊介绍LlamaFactory,修改其代码来实现⾃定义评估指标的计算 | 详细介绍使⽤LlamaFactory微调Qwen3 VL的优化过程 | 使⽤Gradio来展示召回与grouping模型,使⽤vLLM实现⼤模型推理 | 并且介绍常⻅部署的优化技巧,包括KV Cache和PagedAttention、GPTQ和AWQ等⼤模型量化算法、 MQA/GQA/MLA等注意⼒机制优化和推测性解码
基于⼈⼒资源招聘⾏业垂直⼤模型与知识图谱融合检索解决⽅案,通过项⽬学习完成企业级招聘检索系统全流程开发、部署、测试与优化。从Transformer底层原理、⼤模型 SFT+DPO双阶段微调、LangGraph智能体构建、招聘职位实体要素抽取及图谱关系构建,结合实时数据⼯程组件写⼊职位实体到检索引擎,完成招聘AI检索系统构建
招聘领域⼤模型微调能⼒ | ⼤模型服务化部署能⼒ | LangGraph 智能体开发能⼒ | 招聘知识图谱构建能⼒ | 搜索意图识别匹配能⼒ | Kafka+Flink实时数据流处理能⼒ | 基于Kafka消息队列实现业务解耦能⼒ | 搜索推荐(Sug)构建能⼒:基于实体图谱的搜索词补全
招聘领域⼤模型 SFT+DPO 双阶段微调解决⽅案 | 基于 LangGraph 的招聘智能体与知识图谱构建解决⽅案 | 招聘搜索意图识别与实体抽取解决⽅案 | ⼤模型 vLLM ⾼性能推理部署解决⽅案 | ElasticSearch +Redis ⾼并发职位检索解决⽅案 | 基于实体图谱的搜索词推荐(Sug)解决⽅案 | ⼤模型训练显存优化(ZeRO / 梯度检查)解决⽅案 | 招聘检索 badcase 治理与相关性优化解决⽅案
招聘领域⼤模型微调:LoRA/QLoRA微调;SFT监督微调;DPO强化学习对⻬;训练数据清洗、去重、隐私处理;微调显存优化(ZeRO、梯度检查) | ⼤模型服务化部署:vLLM/SGLang推理加速框架;KV Cache缓存机制;模型量化(FP16/INT4);⼤模型服务监控、压测与⾼并发优化 | LangGraph智能体开发:State/Node/Edge 核⼼组件;线性/条件/循环⼯作流构建;⼯具调⽤(Tool Call);招聘职位实体要素抽取及职位实体图谱构建智能体 | 招聘知识图谱构建:职位实体(岗位、结算⽅式、⼯作类型、⼯作时间等)抽取;实体关系泛化与图谱建模;职位要素分类与意图图谱构建;缓存与ES联动更新 | 搜索意图识别:⽤户搜索词意图分类;多意图表达识别;⻓尾搜索词优化;意图与职位要素匹配策略 | 检索系统核⼼技术:Kafka实时数据流处理;近实时职位⼊库与ES检索 | 搜索推荐(Sug):ES Completion Suggester原理;FST数据结构;前端防抖与实时推荐;基于实体图谱的搜索词补全 | 企业级⼯程实践:模块化设计与代码复⽤;配置与环境管理;⽇志与错误处理;分布式部署、负载均衡;Docker/K8s部署思路 | 项⽬优化与评估:检索badcase优化;意图识别准确率提升;⻓尾问题处理;模型与检索效果评测指标 | 就业导向能⼒:⼤模型⾯试考点(Transformer/微调/部署/图谱);业务场景拆解与⽅案设计
课时:0天 技术点:80项 测验:0次 学习方式:录播
学员能够掌握CNN、ResNet、Yolo及分割算法的核⼼原理| 具备开发图像分类与⽬标检测应⽤的能⼒
1. 计算机视觉背景该部分主要学习计算机视觉背景、任务、发展历史介绍,包含以下技术点:
计算机视觉定义| 计算机视觉的任务| 计算机视觉的应⽤领域| 计算机视觉的发展历史
2. 图像分析特性该部分主要学习图像特性分析与图像处理实践,包含以下技术点:
图像的表示⽅法| 图像的IO操作| 图像的颜⾊空间| 图像的加法| 图像混合| 图像的⼏何变换| 图像噪声| 图像平滑⽅法
3. 图像分类该部分主要学习图像分类与图像增强技术实践,包含以下技术点:
图像分类任务详解| 图像分类的数据集| 图像分类的评估⽅法| 常⽤的图像增强⽅法| tf.image进⾏图像增强| imagedatagenrator进⾏图像增强| 模型微调| 数据集获取| 【案例】图像⼏何颜⾊增强实践| 图像分类的CNN⽹络回顾| AlexNet⽹络实践| VGG⽹络架构| GoogLeNet详解与实践| Inception系列⽹络| ResNet⽹络结构与实践| 残差块和瓶颈块| 【案例】鲜花分类案例
4. 图像分割该部分主要学习图像分割核心知识,包含以下技术点:
图像分割定义| 图像分割的类型| 图像分割的开源数据集| 图像分割的评估指标| unet⽹络结构| 语义分割VOC数据集获取| 数据集⽣成器| 模型构建| 编码器实践| 解码器实践| 模型训练| 模型预测| 【案例】基于Unet的VOC数据的语义分割案例| 图像实例分割| MaskRCNN的⽹络构成| MaskRCNN的流程| ROIAlign原理与实践| ⽓球分割数据集的获取| 模型训练| 损失函数的实践| 模型预测| 【案例】MaskRCNN⽓球实例分割实践
课时:0天技术点:70项测验:0次学习方式:录播
能够掌握CLIP与Diffusion的核⼼原理| 独⽴搭建Stable Diffusion⽂⽣图项⽬| 熟练运⽤LoRA、ControlNet等控制技术| 能够基于Qwen系列模型完成图⽂理解任务,并利⽤ms-SWIFT或LlamaFactory框架进⾏⾼效微调,实现从模型训练到部署的完整项⽬落地
项目基于Stable Diffusion,利用稳定扩散过程,通过逐渐模糊和清晰化图像来实现图像生成的过程。这种方法在图像生成领域具有广泛的应用,项目可扩展于艺术创作、虚拟场景生成、数据增强等。
图像生成的常见解决方案| 文图匹配的解决方案| 扩散模型噪声去除的解决方案| 潜在空间扩散模型的解决方案| 扩散模型训练的解决方案| 小程序搭建的解决方案
AIGC的详解:AIGC简介,类型,应用场景,产品形态| 图像生成算法:GAN,VAE,Diffusion,DALLe,imagen| StableDiffusion的详解:Diffusion,latent diffusion;satble diffusion| stablediffusion实践:模型构建,模型训练,lora,dreambooth,图像生成效果| 图像生成小程序搭建:基于stablediffusion构建图像生成的小程序
课程名称:主要针对:主要使用开发工具:
↑ 上拉查看下阶段课程
专职课研团队专职教学团队
标准化研发人才画像
多维面试(五面)
研究院小组诊断测评
全链路面试流程监控
课研人员素质考核
课程设计考核
大纲设计考核
讲义撰写考核
视频录制考核
课堂试炼考核
产品全方位审评
考核答辩
技术开源历练
技术私享会
大牛技术沙龙
企业技术共享
应用市场调研+大
数据分析
获取前沿发展方向
前沿热门课题深入
剖析+技术攻坚,
保障课程前瞻性
基于市场主流技术研
发解决方案,
应对职场难题
基于热门行业领域联合
大牛顾问团,
研发“大厂级”项目
来自华为、IBM等百人大牛团,每年斥巨资,
研发行业标杆优质课程
标准化讲师画像初试技术深度
复试授课质量终试价值观
定制个性化考核方案讲师素质考核
视频录制考核排课、备课产出物考核
教育心理考核教学方法考核
课堂试讲考核正式授课答辩
学员满意度打分阶段课程评审
多维培养计划讲师晋升通道
情景式教学法将教学过程形象化的一种授课方法,集风趣、
知识、故事场景于一体,可大大提高学员对
知识的理解和吸收
场景式授课通过分析场景特点、梳理场景流程、呈
现给定场景下技术的实现3个步骤,向学
员清晰的展现了开发的全流程。
Open教学法OPEN
教学法是由传智教育培训院首创的一套
教学方法论,旨在「用更短的时间讲明白一个
知识点」
提供免费学前咨询及1V1专属学习方案

