从零开启AI之旅6天
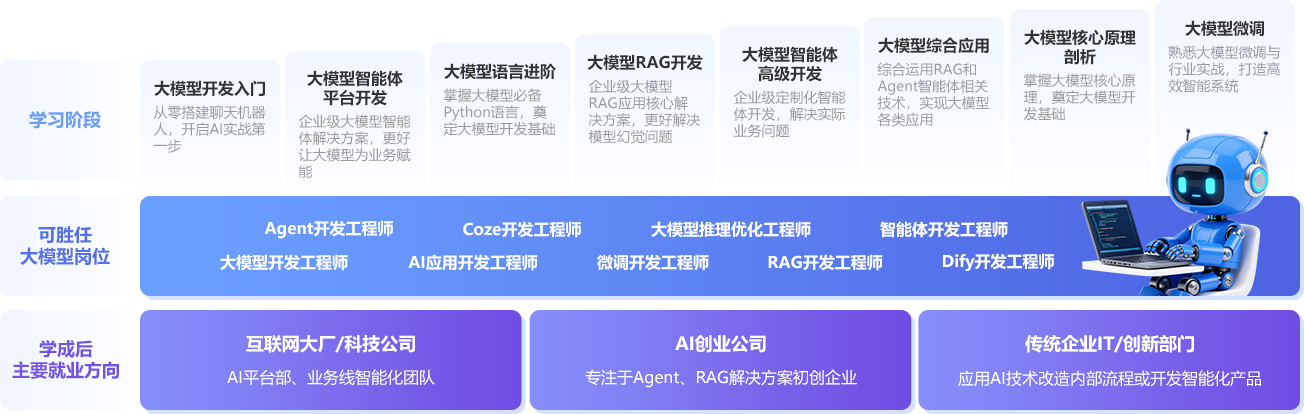
大模型开发入门
动⼿搭建聊天机器⼈,快速⼊⻔⼤模型开发
知识点细分: 本地部署大模型(Ollama);可视化聊天机器人(ChatBox);Python核心语法;Python调用大模型API;搭建聊天机器人

仅需3.5个月即可完成从入门到就业

专科及以上学历、应届生、转行者均可,
完全零基础也无限制

聚焦低门槛、高需求岗位,无需深入
学习复杂的算法,只教企业需要的技能
阶段一大模型开发入门
动⼿搭建聊天机器⼈,快速⼊⻔⼤模型开发
知识点细分: 本地部署大模型(Ollama);可视化聊天机器人(ChatBox);Python核心语法;Python调用大模型API;搭建聊天机器人
阶段二大模型智能体平台开发
金融行业动态风向评估:基于Zero-shot零样本学习能力,通过DeepSeek/QWen/ChatGLM模型对金融领域数据进行分类、信息抽取、文本匹配,更好的解决业务问题
知识点细分:
1. 什么是Prompt Engineering
2. Prompt Engineering的原理以及实际应用的优化技巧
3. 如何利用Prompt Engineering完成实际金融业务
基于Coze搭建智能体,快速从0到1搭建工作流和应用程序
知识点细分:案例讲2练3;1. 案例:智能问答助手;2. 案例:旅游规划小精灵;3. 案例:智能助教;4. 案例:智能面试官;5. 案例:口语练习专家
基于Coze工作流,为黑马程序员AI学科学生临近毕业时面试相关的问题进行提效。结合LLM、ASR、TTS、RAG等技术,为面试中常见的效率痛点赋能,代替部分人工,缓解教师压力
知识点细分:
实现如下功能:
1.
简历修改:基于OCR插件、prompt、数据库查询,实现简历中各类常见问题的召回和修改建议。
以及进阶功能:违禁词过滤、业务背景重复率统计等。辅助学生编写更好的简历
2.
面试录音分析:基于多模态大模型实现ASR,基于prompt实现面试官、应试者角色划分,最终实现文字提取、摘要以及建议,提面试高录音分析的效率
3.
面试题生成:基于黑马面试宝典使用RAG技术结合学生的简历,结合简历上的技能点、业务背景、毕业时间、专业等信息,生成个性化的面试题题库
4.
模拟面试:基于简历和面试题生成流水线等功能,基于邢老师音色克隆面试官音色,结合ASR模型、TTS模型等技术,实现实时语音面试
项目基于Ollama私有化部署DeepSeek R1:8b模型;基于Docker结合Dify大模型应用开发平台构建可视化聊天界面
知识点细分:
1. 大模型私有化部署:Ollama、DeepSeek/QWen
2. 聊天机器人搭建:基于Dify搭建可视化聊天机器人
3. RAG构建:基于Dify搭建本地知识库
4. Agent智能体构建:基于Dify搭建Agent智能体
阶段三大模型语言进阶
AI掘金头条是一款基于个性化推荐的科技资讯阅读产品,包含用户端(提供移动Web、支持阅读、关注、评论及智能客服功能)、自媒体端(供自媒体作者编辑发布文章并查看运营数据)以及MIS管理后台(用于用户管理、文章审核及评论管理)等
知识点细分:
1. 项目搭建:项目初始化、配置数据库与配置模块化
2. 用户模块:获取用户信息,修改头像
3.
头条模块:获取用户频道,获取所有频道,修改用户频道
4.
文章模块:获取文章详情,用户关注列表,发布评分与评论列表及回复评论
阶段四大模型RAG开发
构建一个端到端、可水平扩展的检索增强生成(RAG)系统,支持对异构简历(PDF/DOCX/JPG/PNG)进行自动解析、结构化、语义索引与多轮对话式推荐。系统以向量数据库为核心存储,以 LLM 为推理中枢,以 Agent 框架为调度单元,面向企业 HR 及猎头平台提供秒级、可追溯、可解释的候选人推荐服务
知识点细分:
1. 文档智能
2. 向量化与索引
3. 检索增强生成
4. 智能代理
5. 配置与 DevOps
阶段五大模型智能体高级开发
1. Pytorch安装;2. Pytorch构建神经网络;3. Pytorch案例实战
1. 机器学习基础(术语、建模流程、核心框架、评估指标、分类回归聚类基础及案例);2. 深度学习基础(神经网络基础、Pytorch框架加强);3. 词向量(Word Embedding)
1. Function Call的原理;2. MCP和Function Call的区别;3. SSE、AGUI、MCP、A2A协议;4. 基于LangGraph智能体开发;5. 大模型评估
扫智通Agent项目是一个面向消费者(toC)的智能客服系统,旨在为用户提供全周期的扫地机器人相关服务并根据用户使用习惯生成使用报告,为用户提供使用优化建议。该系统基于RAG技术及ReAct框架构建,能够同时处理用户购买前后的咨询问题以及已购买用户的使用报告生成与优化建议需求。通过一个统一的Agent界面,为用户提供高效、准确且个性化的支持,提升用户体验与满意度
知识点细分:
1.数据来源:扫地机器人的产品手册及相关知识库(基础与技术类、产品功能类、智能交互类、维护与保养类、选购指南类、使用技巧类、配件与耗材类、安全与隐私类、特殊场景类等问题)
2.基于ReAct框架实现的Agent,包括推理(Reasoning)模块以及行动(Acting)模块
3.使用RAG工具实现本地知识库构建。(文档读取模块、向量数据库模块、RAG工具调用模块)
4.使用大模型Deepseek v3结合Prompt
Engineering实现用户使用报告的生成
5.构建三位一体评估体系,针对检索内容(Precision、Recall、mrr)、生成内容(ROUGE-1、ROUGE-L、BERTScore、Faithfulness)、总性能(平均延时、QPS)
6.构建日志打印模块,重点监控工具的运行情况。(控制台日志+生产环境日志)
7.基于Flask的模型部署(服务端+客户端)、基于Streamlit的前端服务
SmartVoyage 是一个智能旅行助手系统,使用 A2A (Agent-to-Agent) 协议构建多代理协作框架,支持用户查询天气和票务信息。系统包括 LLM 路由服务器(意图识别)、天气代理服务器(查询天气数据库)、票务代理服务器(查询票务数据库)、MCP 工具服务器(数据库接口)、数据采集脚本和 Streamlit 前端客户端。用户输入查询(如“北京天气”或“北京到上海火车票”),系统通过 LLM 路由到合适代理,代理生成 SQL 查询 MCP 数据库,返回结果显示在界面
知识点细分:
1. LLM 路由服务器(意图识别)
2. 天气代理服务器(查询天气数据库)
3. 票务代理服务器(查询票务数据库)
4. MCP 工具服务器(数据库接口)
5. 数据采集脚本
6. Streamlit 前端客户端
阶段六大模型综合应用
“草本通” 项目致力于解决中医药知识难以理解、碎片化严重、检索效率低 等问题,打造一个可理解、可对话、可传播、可拓展 的智能知识服务平台。系统融合多种AI技术,支持从数据采集到语义问答、图谱构建、再到内容生成与平台发布的完整AI闭环
知识点细分:
1.
利用爬虫自动采集中药、方剂、功效、症状、疾病等原始文本
2. 使用大语言模型(DeepSeek)+ LangChain
进行实体与关系抽取
3. 构建 Neo4j 图数据库与 Faiss
向量检索双引擎,实现结构化查询与语义匹配
4. 基于 LangGraph
搭建多智能体协同系统,管理复杂问答流程
5. 提供基于 Streamlit 的网页端交互式问答界面
6.
自动生成小红书风格图文内容,并实现一键发布,实现从“知识获取”到“内容传播”的闭环
基于IT职业教育行业答疑大模型抽取RAG解决方案,通过项目学习完成企业及RAG系统完整流程搭建与测试及优化。从智能查询路由设计、数据处理与多源集成、模型微调到后端服务与前端开发完成全栈RAG系统构建
知识点细分:
1.智能问答系统架构:FAQ 系统与 RAG
系统的区别与应用场景
2.数据库技术:MySQL 表查询;Redis
键值存储与缓存机制;Milvus
向量数据库的架构与索引类型
3.检索算法:BM25 算法原理;密集向量 &
稀疏向量混合检索;重排序的作用
4.query的意图识别+改写:BERT
分类器的训练与推理;LLM的调用与提示设计;查询分类与动态检索策略的实现逻辑
5.企业级开发实践:模块化代码设计与代码复用;配置文件(config.ini)与环境变量管理;日志系统设计与错误处理
大型ToC企业中的客服团队往往是人力外包,对公司业务细节的了解程度不够,需要和产研团队多次沟通才能完成一次工单的处理,效率低下。 同时,随着AI的发展,工单的处理也可以基于大模型+RAG+funcation call能力进行提效,部分工单自动处理,从而节省部分客服人力资源。 本系统结合大模型能力,融合多种AI技术(RAG+多Agent+MCP)等,完成工单的判定、处理、建议等全流程流转闭环
知识点细分:
1. 项目冷启动阶段,基于大模型 +
NLP算法,完成工单数据的清洗和工单、业务知识库的搭建(ElasticSearch),工单会进行脱敏
2.
消费工单的Kafka消息队列数据,并基于规则过滤出来需要处理的工单
3.
实现query改写,提高检索内容的准确性,对ES进行检索时采用上下文+向量混合检索的方式,结合重排序模型实现查询内容的准确性
4.
实现意图识别和槽位填充,基于用户的query基于MCP协议执行funcation
call,在上下文中补充用户的实时数据作为上下文信息
5. 实现知识库实时迭代,
实现知识库数据实时更新,保证内容是最新的
6. Docker镜像的构建和生产环境docker-compose模式部署
Flask/FastAPI/Gradio;Docker安装与部署;接口文档;模型部署实战
Agent常见架构剖析
DeepSeek大模型架构剖析
大模型Agent开发常见面试题
大模型RAG开发常见面试题
常用数据结构常见面试题
阶段七大模型核心原理剖析
1. Transformer架构
2. 大模型Transformer架构的注意力机制
3.
大模型Transformer架构(encoder、decoder、encoder+decoder)
4. 大模型Transformer文本翻译实战
1. 迁移学习的预训练模型和微调阶段
2. NLP中的常用预训练模型(BERT、GPT-1、GPT-2)
3. Hugging Face预训练模型仓库
4. Huggingface
Transformers库使用(提供了NLP领域预训练语言模型结构模型和调用框架)
5. Bert文本分类案例
阶段八大模型微调
1.主流大模型原理及架构(GPT系列、GLM、QWen、DeeepSeek)
2.大模型微调策略(PET、P-Tuning、LoRA
基于Qwen/DeepSeek+LoRA微调实现微博文本信息抽取+文本分类的多任务,通过一个大模型同时解决多种任务开发和应用,项目基于LLM进行混合任务开发应用的实现, 利用Qwen/DeepSeek大模型进行P-Tuning微调的方式,基于Flask框架实现API接口开发和应用
知识点细分:
1. 理解信息抽取任务以及文本分类的业务意义及应用场景
2. 数据预处理:修改数据格式适配大模型训练、数据张量的转换等
3.Qwen/DeepSeek模型解析,LoRA方法讲解、P-Tuning方法解析
4. 基于Qwen/DeepSeek+LoRA方法实现模型的训练和评估
5. 基于Qwen/DeepSeek+P-Tuning方法实现模型的训练和评估
6. 基于Flask框架开发API接口,实现模型线上应用
项目以QWen模型为核心,借助DeepSpeed框架实现训练过程的加速优化。同时采用了GPTQ和QLoRA技术对模型进行量化处理,旨在进一步提升模型的推理速度。最终,通过Vllm平台完成了模型的部署,实现了对文本中关键信息的自动化抽取,完成信息抽取的任务
知识点细分:
1. 数据集处理、模型构建、模型训练、模型预测
2. 大模型并行计算:deepspeed,数据并行、流水线并行、模型并行
3. 大模型量化:训练量化方法QLora,训练后量化方法GPTQ
4. 模型部署和推理优化框架:vLLM和oLLAMA
聚焦RAG开发、Agent智能体、国产模型微调三大黄金赛道

企业级大模型RAG应用核心解决方案,更好解决模型幻觉问题
掌握企业级大模型智能体解决方案,更好让大模型为业务赋能

掌握机器学习与深度学习核心算法,能够解决基础人工智能问题
课程充分融入DeepSeek,无缝对接企业大模型开发
使用技术、流程、工具、评估方法(如RAG的三位一体评估体系)都紧贴企业实践
聊天机器人搭建
(私有化部署)
AI掘金头条
(Python Web项目)
Coze/Dify项目案例
扫智通客服
(ReAct框架)
旅行规划
(A2A多Agent协作)
物流知识问答机器人
人力资源简历推荐系统
中医药知识图谱系统
职业教育RAG问答系统
多场景工单系统
(强化RAG+Agent)
微博信息抽取
文本摘要
 解决业务痛点
简历优化、面试分析、工单自动处理、行业知识问答(如医疗、物流、旅游、人力等)
夯实技术深度
结合RAG防幻觉、ReAct/A2A多智能体协作、混合检索(BM25+向量)、实时日志监控
提升就业竞争力
建立工程化思维,独立完成复杂系统,掌握解决企业级需求能力
使用技术、流程、工具、评估方法(如RAG的三位一体评估体系)都紧贴企业实践
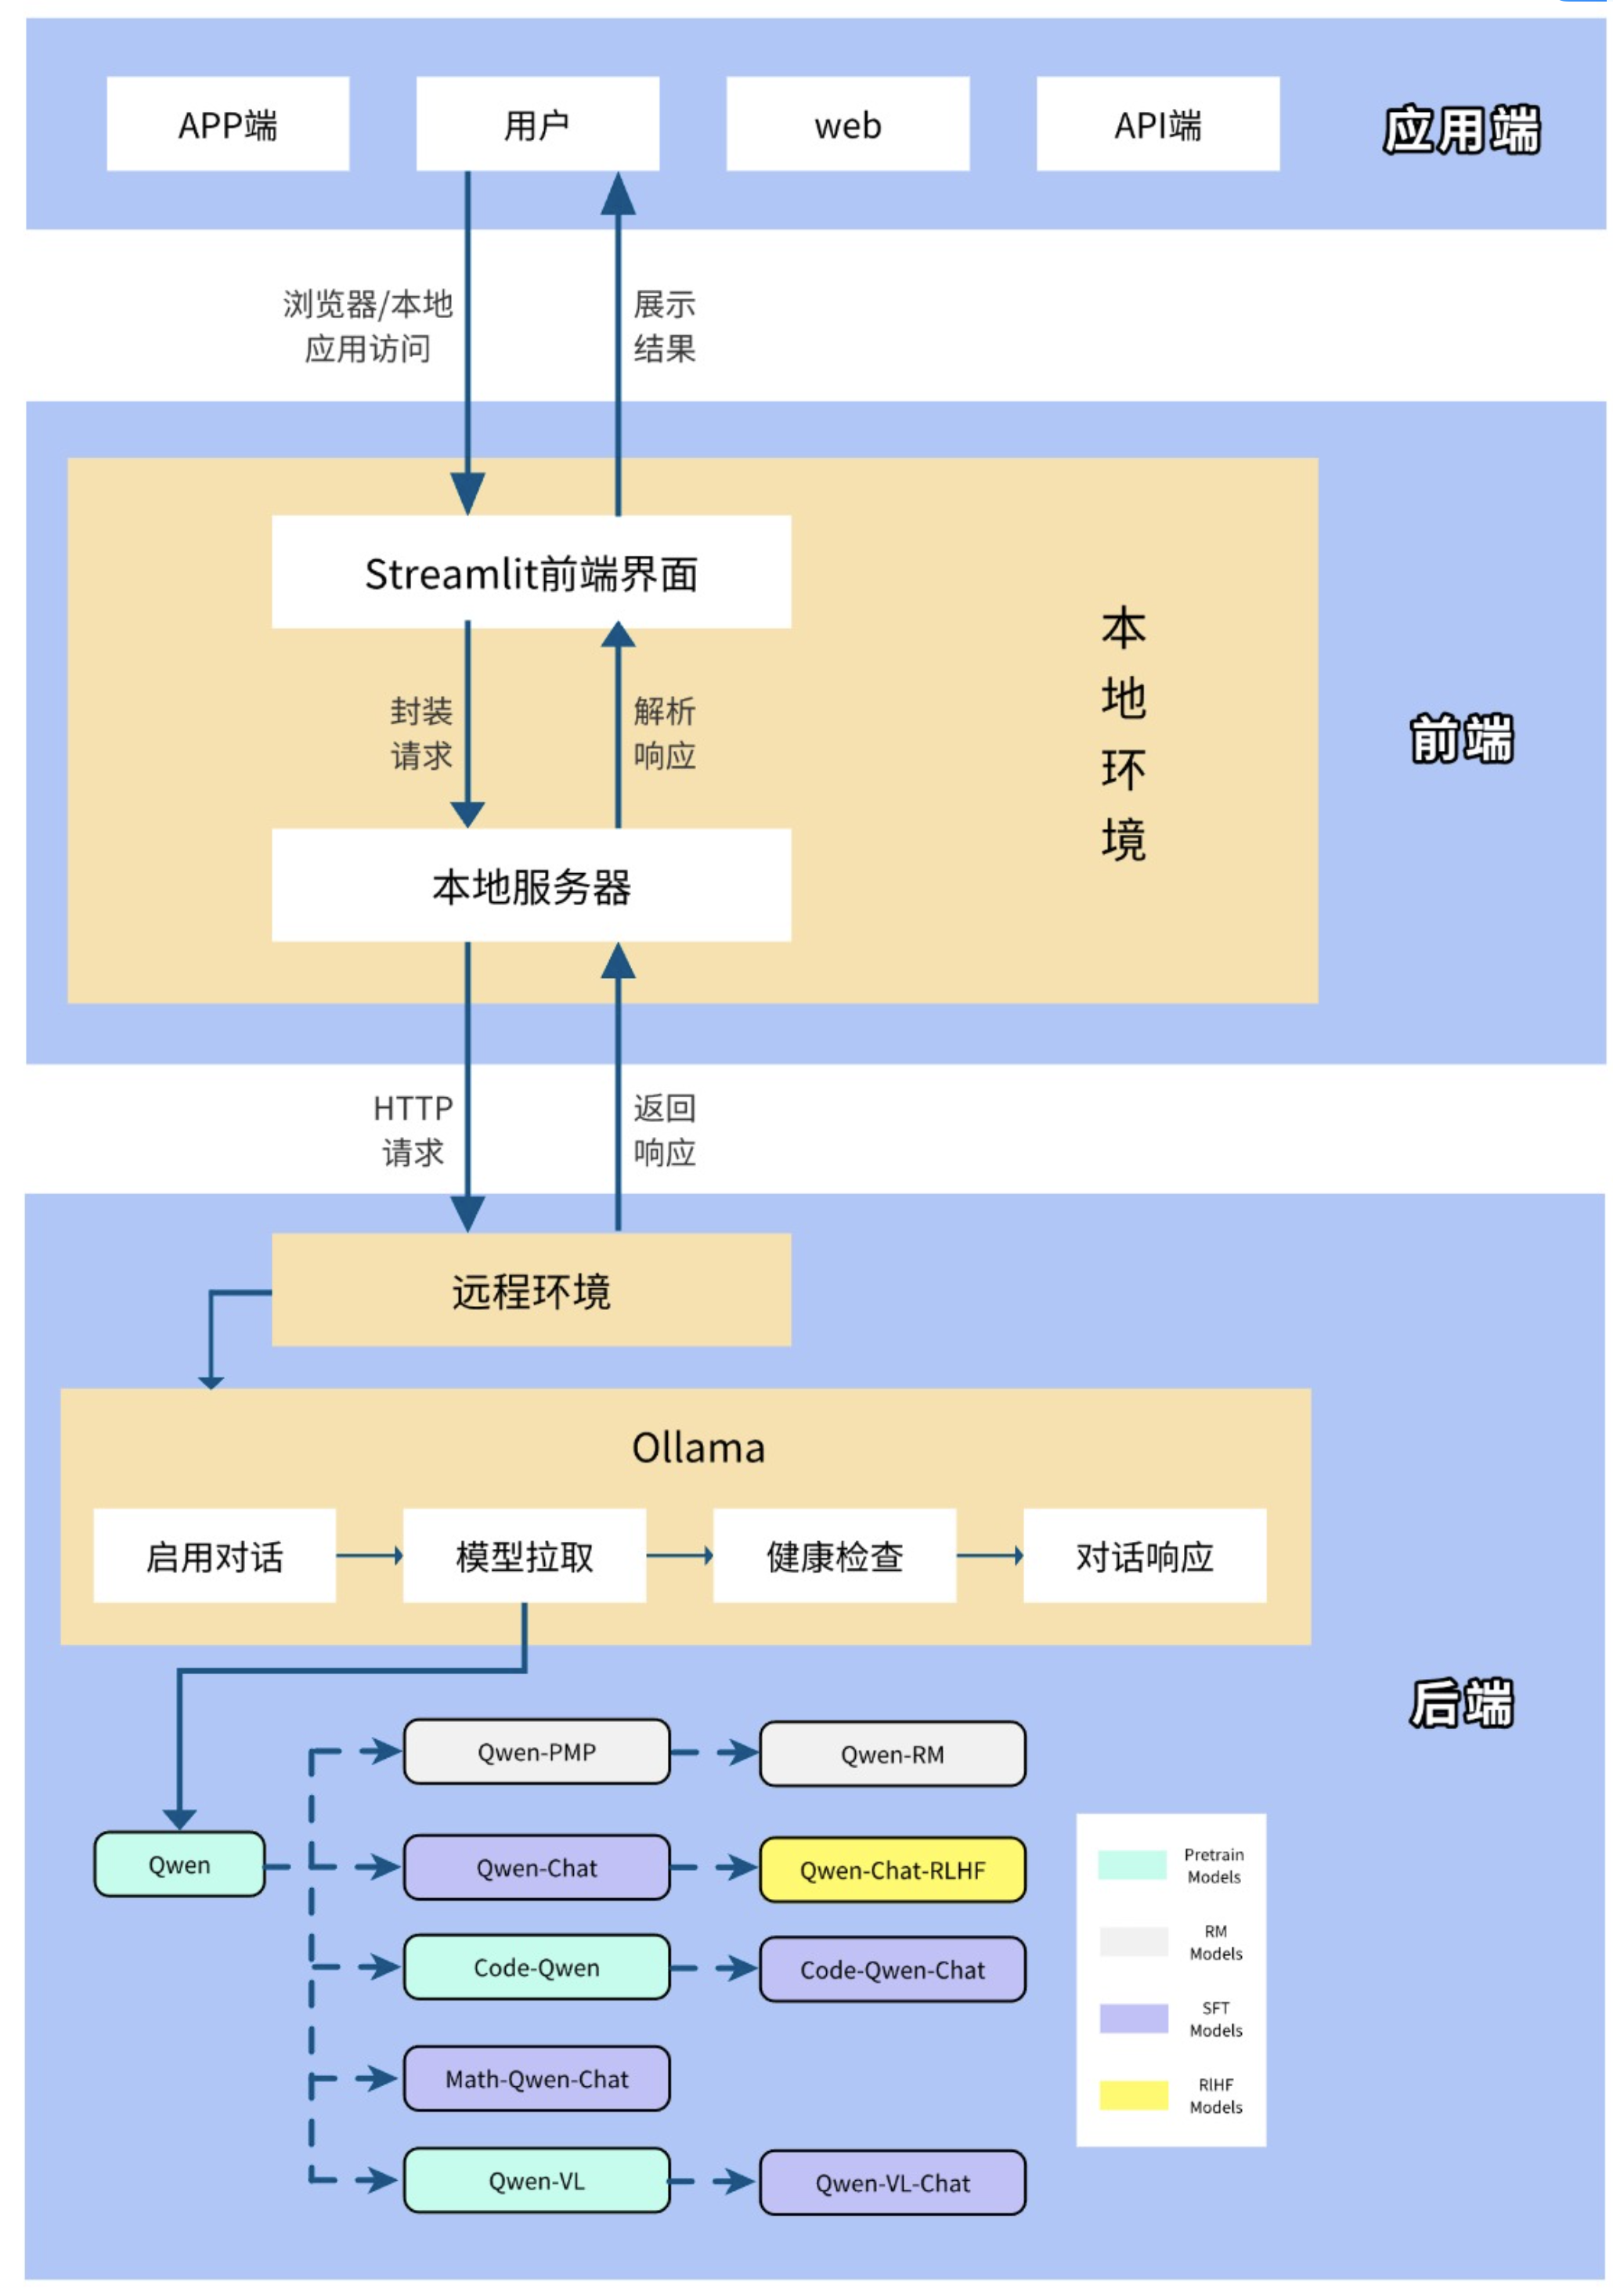
项目基于Ollama私有化部署DeepSeek R1:8b模型,基于Docker结合Dify大模型应用开发平台构建可视化聊天界面,并搭建人工智能技术答疑场景的RAG系统,通过集成DeepSeek构建专属AI助手,解决模型幻觉问题。并且通过DeepSeek构建企业应用智能体。项目实现了AI大模型从私有化部署、聊天机器人搭建、RAG系统到Agent智能体构建。
可掌握的核心能力
1.掌握大模型部署方案
2.掌握Dify大模型应用开发平台使用
3.掌握基于Dify构建RAG系统
4.掌握基于CrewAI的Agent智能体构建
技术亮点
大模型私有化部署方案
Dify搭建聊天机器人
搭建本地知识库解决方案
大模型智能体解决方案
技术架构图
蜂窝头条投满分项目是结合今日头条真实场景下的海量数据, 快速搭建随机森林和FastText的基线模型, 以验证商业化落地的可行性. 更多聚焦在深度学习的优化方法上, 搭建基于BERT的初版微调模型, 应用量化,剪枝,预训练模型微调,知识蒸馏等多种手段,反复迭代,反复优化模型的离线效果,在线效果。
可掌握的核心能力
1. 基于大规模业务留存数据构建快速文本分类系统
2. 基于推荐系统内部分频道投递的需求,
快速搭建短文本精准分类投递的模型
3. 基于随机森林和FastText搭建快速基线模型,
验证业务通道的能力
4. 基于BERT的迁移学习优化模型搭建的能力
5. 实现神经网络量化的优化与测试
6. 实现神经网络剪枝的优化与测试
7. 实现神经网络知识蒸馏的优化与测试
8. 更多主流预训练模型的优化与深度模型剖析
9. BERT模型在生成式任务和工程优化上的深入扩展
技术亮点
海量文本快速分类基线模型解决方案
基于预训练模型优化的解决方案
模型量化优化的解决方案
模型剪枝优化的解决方案
模型知识蒸馏优化的解决方案
主流迁移学习模型微调优化的解决方案
技术架构图
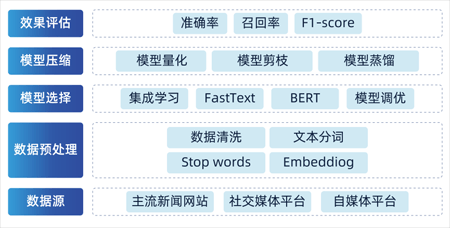
医疗知识图谱项目是一款基于知识图谱的多功能问答机器人项目, 主要解决当前NLP领域中大规模知识图谱构建的问题和图谱落地的问题.知识图谱的构建主要分为知识构建和知识存储两大子系统.知识构建部分将重点完成命名实体识别和关系抽取的模型搭建与优化,深入解析并实现Casrel模型实现文本自动关系抽取的实现.并深入解析实体对齐和实体消歧的NLP难题解决方案, 深度结合工业界流行的解决方案. 最终呈现一个基于知识图谱的问答机器人。
可掌握的核心能力
1.图谱全流程管理 —— 掌握从数据获取到图谱构建的全生命周期。
2.图谱理论与应用 —— 熟悉知识图谱定义、类型及多领域应用。
3.Neo4j 技术 —— 精通图数据库的存储与查询优化。
4.深度学习 NER —— 掌握 CRF、BERT、BiLSTM+CRF
等实体识别方法。
5.多样化关系抽取 —— 熟练运用规则、Pipeline 与 Casrel
模型提取关系。
6.知识融合与消歧 —— 掌握实体消歧和关系对齐技术。
7.医疗问答开发 —— 实现意图识别与对话管理的智能问答系统。
8.NLP 语义处理 —— 精通自然语言理解(NLU)与生成(NLG)。
9.模型工程化 —— 掌握数据预处理与模型训练全流程。
10.垂直领域图谱 —— 构建医疗、商业等领域的定制知识图谱。
技术亮点
智能搜索优化 ——
利用语义理解与实体关联提升搜索准确性(图谱智能搜索)
医疗诊断与研发 —— 构建医疗知识图谱,支持疾病诊断及药物研发
高效知识存储与查询 —— 基于 Neo4j 存储与查询 SPO 三元组数据
智能问答系统 —— 结合 NLU 与知识图谱实现精准问答
异构数据整合 —— 通过实体抽取融合多源数据构建一致知识图谱
技术架构图
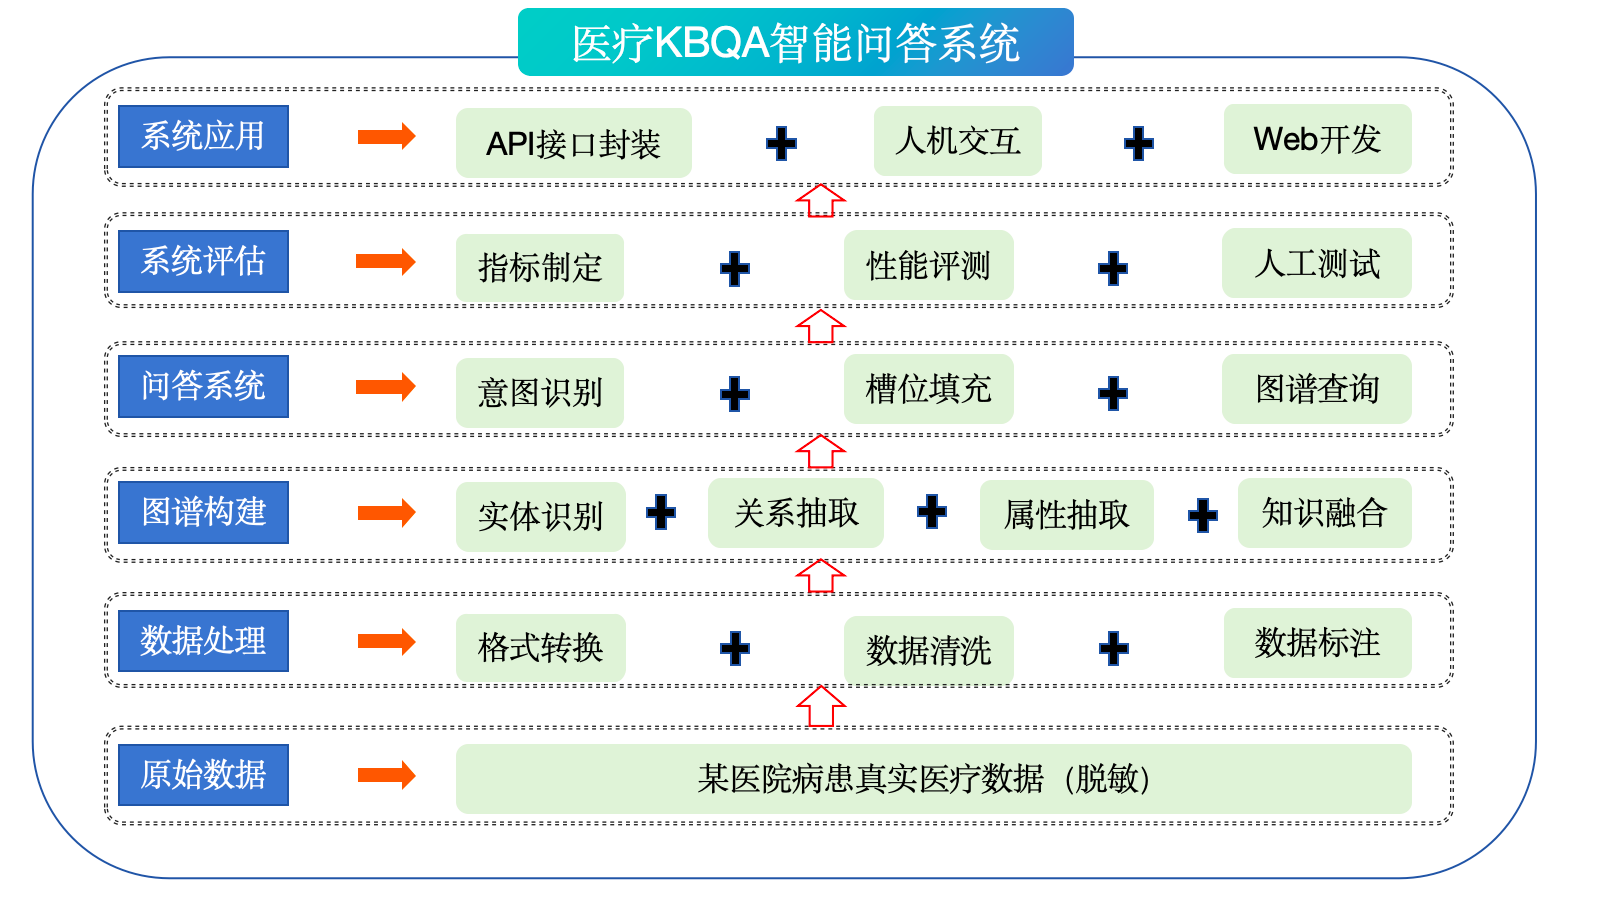
基于ChatGLM/QWen+LoRA微调实现微博文本信息抽取+文本分类的多任务,通过一个大模型同时解决多种任务开发和应用,项目基于LLM进行混合任务开发应用的实现,利用ChatGLM/QWen大模型进行P-Tuning微调的方式,基于Flask框架实现API接口开发和应用。
可掌握的核心能力
1.了解和掌握大语言模型的基本原理和架构,特别是ChatGLM/QWen模型的结构和工作机制。
2.掌握大模型LoRA微调技术,通过微调预训练的大模型来适应特定任务的需求。
3.掌握大模型P-Tuning微调技术,对大模型进行高效的参数调整,增强其在特定任务上的表现。
4.理解和应用多任务学习的概念,通过一个模型同时解决文本信息抽取和文本分类两种任务,提高模型的综合能力和应用效率。
5.掌握文本信息抽取技术,从非结构化的文本数据中提取有价值的信息,如实体、关系、事件等。
6.学习文本分类的基本原理和方法,掌握如何将文本数据按照预定义的类别进行归类。
7.通过Flask框架,学习如何开发和部署API接口,使模型能够通过网络服务被访问和使用。
技术亮点
联合任务数据预处理适配模型训练的解决方案
实现ChatGLM/QWen+LoRA训练的解决方案
实现ChatGLM/QWen+P-Tuning训练的解决方案
基于Flask框架实现模型API接口开发的解决方案
技术架构图
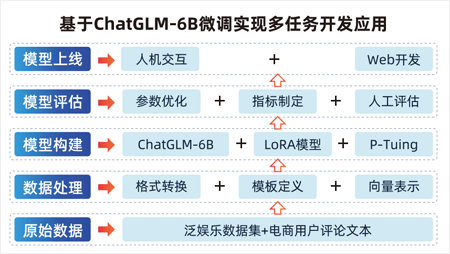
项目基于LangChain+ChatGLM/QWen实现电商物流本地知识库问答机器人搭建,让模型根据本地信息进行准确回答,解决大模型的“幻觉”问题,实现精准问答。通过项目皆在掌握LangChain工具的基本使用方式,理解向量知识库以及实现知识库的技术原理,快速构建检索增强生成(RAG)系统。
可掌握的核心能力
1.掌握LangChain工具的基本使用方法,了解如何通过LangChain构建和管理语言模型应用。
2.熟悉ChatGLM/QWen模型的应用,了解如何将大语言模型与本地知识库结合,实现高效准确的问答功能。
3.理解向量知识库的基本概念和技术原理,掌握如何构建和使用向量知识库来存储和检索知识信息。
4.掌握知识库的构建方法,从数据采集、处理到存储,学习如何将电商物流相关信息整合到知识库中。
5.理解RAG系统的基本原理和实现方法,学习如何结合检索和生成技术,提升问答系统的准确性和实用性。
6.从零开始搭建一个问答机器人,掌握整个系统的设计、实现和部署过程。
技术亮点
LangChain工具使用介绍解决方案
ChatGLM/QWen模型集成到问答系统中的解决方案
向量知识库的构建和检索的解决方案
搭建RAG系统的解决方案
技术架构图
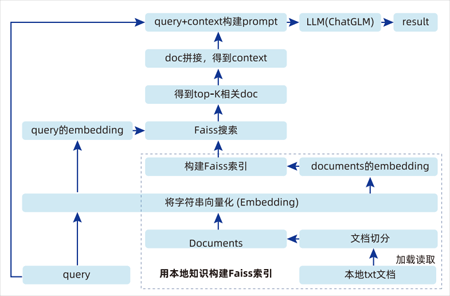
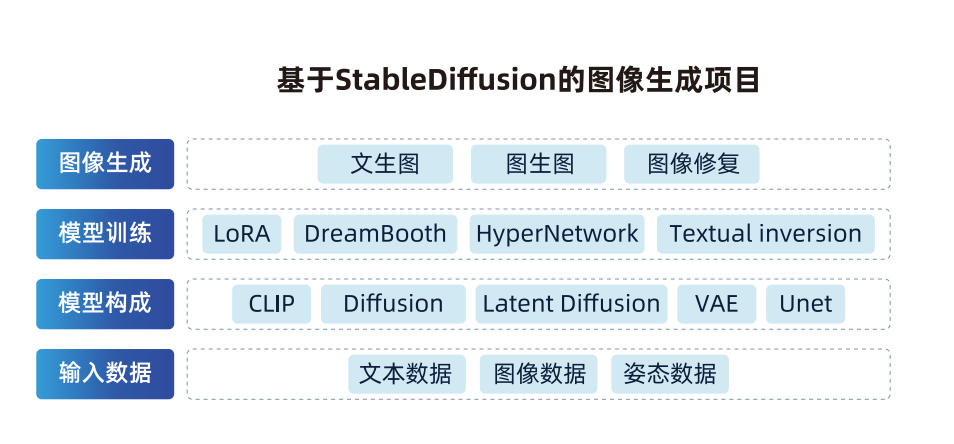
基于Stable Diffusion的图像生成项目是一种基于深度学习的图像生成方法,旨在生成高质量、逼真的图像。该项目利用稳定扩散过程,通过逐渐模糊和清晰化图像来实现图像生成的过程。这种方法在图像生成领域具有广泛的应用,包括艺术创作、虚拟场景生成、数据增强等。
可掌握的核心能力
1. 知道AIGC是什么,理解AIGC的产品形态
2. 知道图像生成的常用方式
3. 理解GAN ,VAE,Diffusion的思想
4. 掌握StableDiffusion的网络结构
5. 理解文图匹配的clip模型
6. 理解Unet网络和采样算法的作用
7. 知道VAE解码器的作用
8. 知道drembooth和lora的模型训练方式
9. 能够搭建图像生成的小程序
技术亮点
图像生成的常见解决方案
文图匹配的解决方案
扩散模型噪声去除的解决方案
潜在空间扩散模型的解决方案
扩散模型训练的解决方案
小程序搭建的解决方案
技术架构图
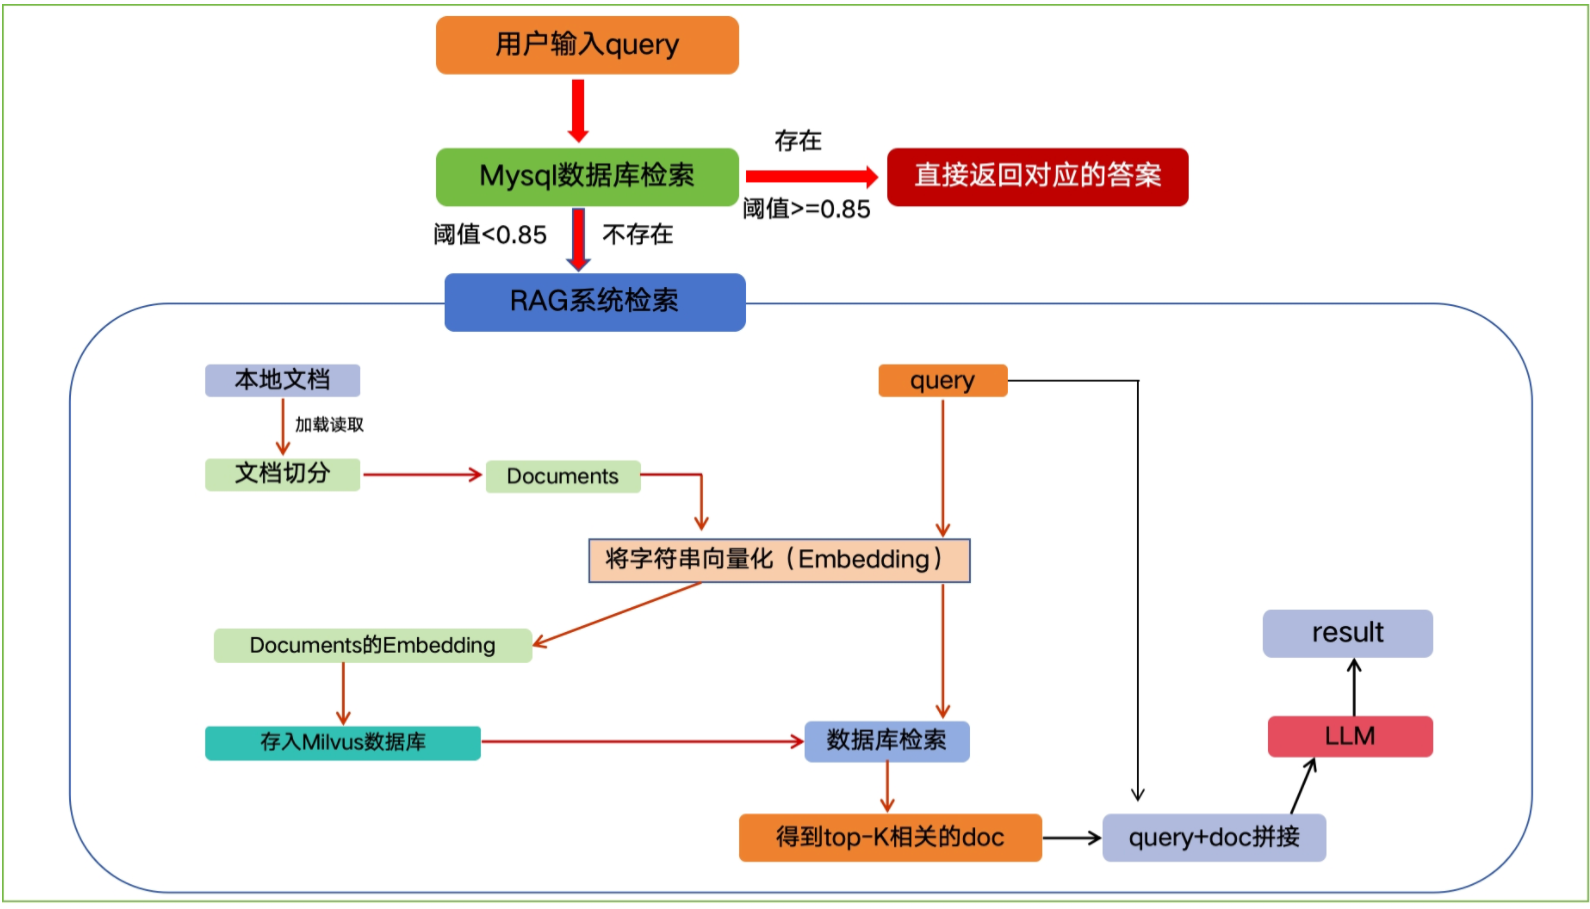
EduRAG 是一个企业级智能问答系统,专为教育场景设计,整合了基于 MySQL 的快速 FAQ 检索和基于 RAG(Retrieval-Augmented Generation)的复杂问题处理能力。系统通过结合 MySQL 数据库的高效查询和 Milvus 向量数据库的语义检索,实现了从常见问题到专业咨询的全方位问答支持。系统支持多来源过滤(如 AI、Java、测试、运维、大数据),并通过 Redis 缓存优化性能,使用 LLM 提供高质量答案生成。
可掌握的核心能力
1.
了解LangChain基本概念、明确LangChain主要组件的作用、了解LangChain常见的使用场景
2.
掌握基于LangChain+ChatGLM-6B模型实现本地知识库的问答实现原理+过程
3. RAG 系统开发与优化:掌握从数据分片到答案生成的 RAG
全流程,熟练应用 HyDE、子查询等检索增强策略提升系统性能。
4. 大模型应用实践:能够集成 LLM(如 OllamaLLM)并设计高效
Prompt,解决知识问答中的业务定制化需求。
5. 智能查询路由设计:实现规则、相似度和 LLM
三层路由,精准分发查询并优化复杂意图识别效率。
6. 后端服务与前端开发:使用 FastAPI 开发高并发 API 并通过
Gradio 构建交互界面,满足企业级服务与用户体验要求。
7. 数据处理与多源集成:熟练处理结构化与非结构化数据,结合
MySQL 和向量搜索打造高效知识检索系统。
8.
企业级问题解决能力:通过日志调试和高并发设计,具备定制化开发与性能优化的实战技能,适配智能客服等场景。
技术亮点
数据库查询优化:BM25 + Redis 缓存
语义检索:Milvus 混合向量检索
查询分类:BERT 分类器
动态检索策略:LLM
驱动的策略选择(直接检索、HyDE、子查询、回溯)
答案生成:LLM + RAG 提示模板
性能优化:Redis 缓存 + 模块化设计
日志与监控:统一日志系统(logging)
配置管理:ConfigParser + config.ini
技术架构图
北京化工大学工学硕士,多家互联网公司首席信息官,算法专家,具备多年机器学习,深度学习等人工智能相关算法的研发经验。熟悉Python、Java等常用开发语言,对PyTorch,Tensorflow, PaddlePaddle等深度学习框架熟练使用,在自然语言处理应用方面具备多年的企业实践经验。
硕士,擅长人工智能领域技术,多年模式识别和数据挖掘开发经验,主导研发多项国家和省级科研项目,负责企业级信贷风控模型和智能医疗数据平台开发,专注ML/DL/PR/KG领域相关算法的应用,曾任职美团搜索部负责NER及Bert搜索排序优化对Hadoop、SparkTensorflow和PyTorch等大数据、人工智能技术有多年企业实践经验。
毕业于哈尔滨工程大学,擅长GIS行业工程实战,在图像分割、检测、追踪等方面有多年从业经历,参与多项国家级/部委级重大项目,具备丰富的工程落地经验。
毕业于北京航空航天大学,聚焦自然语言处理算法和大模型方向,曾在多家知名互联网企业担任高级算法工程师和算法团队负责人,参与或主导多个核心算法项目的工业化落地,深谙工业界对算法工程师的核心诉求。在大模型引发AI范式变革之际,致力于以工业标准重塑教学,将多年算法能力和工程经验惠及更多的学员,希望大家都能学到真本领,进入自己心仪的企业。
硕士,曾就职于多家上市公司,并担任高级算法工程师、算法专家。研究领域包括NLP、目标检测、视频跟踪、大语言模型、多模态、模型推理加速等。
985高校计算机专业,资深算法工程师,在央企以及互联网公司从事多年算法开发及管理工作,在数据挖掘、自然语言处理、对话机器人领域有着深刻理解。。擅长课程:数据挖掘、数据分析与可视化、自然语言处理、信息抽取、对话机器人、大模型。
多年互联网一线大厂经验,在字节跳动、滴滴出行等一线互联网公司核心业务部门深耕技术多年,专注大数据和人工智能领域,具备扎实的技术能力和前沿的技术视野,技术栈丰富,擅长大数据开发、数据挖掘、深度学习、NLP、大模型等技术,擅长对技术活学活用和解决复杂问题,具备丰富的大型项目实战经验。
毕业即签约,3.5个月实现技能变现,薪资涨幅最高达300%
29岁本科,规划设计师转AI大模型,培训前12500,培训后28000
29岁本科,电子商务专业,南京就业,培训前14000(北京)培训后16000
22岁大专,机械制造与自动化转行AI大模型,培训前4000,培训后16600
29岁,专升本,建筑工程师转行AI大模型开发,培训前8000,培训后21000
23岁,大专,网络系统管理专业,北京就业,培训后薪资12000
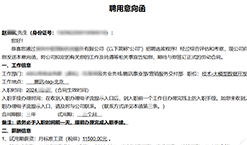
23岁,本科,数据运营转行AI大模型,培训前7000,培训后16000
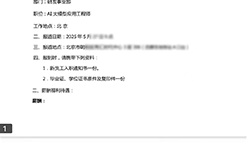
薪资数据来源:黑马学员内部就业数据
本课程旨在培养具备企业级大型模型应用开发能力的工程师(目标岗位:大型模型应用工程师。从事的岗位:将具备应聘大型模型应用、AI智能体开发工程师、RAG开发工程师等相关岗位的核心技能。
课程适学人群为:零基础学生。它包含 6天的“大模型开发入门”基础班 ,会教Python核心语法、基础API调用和本地模型部署。
课程为线下全日制脱产班。课程时长约70天学习日,不含休息日。总服务天数约106天。
课程主要聚焦于主流大模型的应用开发,重点实践平台包括:DeepSeek-R1, QWen, ChatGLM ;教学重点在于如何使用这些模型的API和本地部署(Ollama),以及在其基础上开发应用(Agent, RAG);课程侧重于 应用层的开发技能和工程实践 (如Prompt工程、Agent框架、RAG构建、部署、项目流程)。
项目采用小组协作(如3-5人)的方式进行 ,模拟真实工作环境。课程配备讲师和助教全程进行技术辅导、答疑和项目评审。
大模型应用开发(特别是Agent、RAG方向)是AI领域最热门的就业方向之一 ,人才需求缺口大。合格的初级工程师起薪通常具有竞争力(远高于普通开发岗位),有经验或能力突出者薪酬潜力更大。
核心技术阶段
深度合作共建课程
热门就业方向覆盖
AI原生多场景实战项目
亦能触达的⾼薪赛道
能力画像:掌握人工智能Python语言,掌握模型私有化方法,能够通过Python调用私有化部署API实现通用聊天机器人搭建
胜任岗位:初级AI开发工程师
参考薪资:10K-12K
能力画像:掌握利用Python进行数据处理及数据统计分析,为数据建模奠定技术基础。同时通过Coze和Dify构建工作流和智能体开发,快速构建智能体。
胜任岗位:数据分析师、Coze开发工程师、Dify开发工程师
参考薪资:10K-14K
能力画像:掌握机器学习、深度学习与NLP核心算法,能够解决模型构建和训练关键问题
胜任岗位:机器学习工程师、深度学习工程师、算法工程师
参考薪资:15K-18K
能力画像:通过LangChain框架完成大模型RAG功能定制化开发
胜任岗位:RAG开发工程师、智能体全栈开发工程师
参考薪资:18K-20K
能力画像:通过LangGraph框架完成Agent Workflow及Agent Loop、Agent Harness等定制化开发
胜任岗位:gent开发工程师、智能体全栈开发工程师
参考薪资:20K-24K
能力画像:设计、实现与优化垂直领域大模型
胜任岗位:大模型开发工程师、算法工程师、大模型算法专家、大模型训练/推理开发工程师
参考薪资:20K-35K
能力画像:通过图像和视频分析、物体识别等技术,实现机器视觉相关任务
胜任岗位:CV算法工程师、目标检测工程师、图像处理工程师、深度学习工程师
参考薪资:15K-20K
课程大纲
入门试学班
1. 大模型开发入门
高手班
1. 大模型语言进阶 2. 提示词工程 3. 智能体平台开发 4. 大模型核心开发技术 5. NewsCompass投满分项目 6. 大模型RAG开发 7. RAG项目(2选1) 8. 大模型智能体定制开发 9. Agentic Workflow(2选1) 10. Agent Loop(3选1) 11. Agent Harness 12. 大模型微调开发基础 13. 微博文本信息抽取和摘要 14. 大模型微调综合项目(2选1)
赠送
1. 图像分析基础 2. 多模态大模型应用开发
AI大模型开发V6.5版本
课时:8天 技术点:60项 测验:1次 学习方式:线下面授
理解⼤语⾔模型基本原理| 熟悉主流⼤模型及应⽤场景| 掌握Prompt提示词设计⽅法| 理解Agent、RAG、Workflow掌握Coze智能体开发| 掌握知识库与RAG应⽤| 掌握插件与⼯具调⽤| 掌握⼯作流编排与应⽤| 掌握Python基础语法| 掌握流程控制与容器操作| 掌握函数的定义与调⽤掌握⽂件及异常处理| 理解Vibe Coding开发模式| 熟悉AI编程⼯具使⽤| 掌握⼤模型与知识库接⼊能够完成基础AI项⽬开发
1. AI⼤模型概述零基础入门AI大模型开发的开始,包含了以下技术点:
什么是⼤语⾔模型(LLM)| ⼤模型能做什么(⽂本⽣成、对话、推理、翻译、摘要)| 主流⼤模型介绍(GPT系列、Claude、通义千问、⽂⼼⼀⾔、 DeepSeek等)| ⼤模型的边界与局限(幻觉、知识截⽌、上下⽂窗⼝)
2. ⼤模型应⽤形态了解AI大模型应用形态,包含了以下技术点:
API调⽤模式| 聊天对话模式| 智能体Agent模式| RAG知识库问答模式| 多模态应⽤模式(⽂⽣图、图⽣⽂、⽂⽣视频)
3. ⾏业落地场景概览了解AI大模型行业落地场景,包含了以下技术点:
AI客服、AI教育、AI医疗、AI办公、AI营销、AI编程等典型案例| 从场景到产品的转化逻辑
4. Coze智能体开发掌握Coze智能体开发,包含了以下技术点:
Coze平台定位(⼀站式AI智能体开发平台)| Coze国内版vs国际版| 平台核⼼能⼒:Bot创建、知识库、插件、⼯作流、发布多端
5. 对话式智能体搭建该部分主要学习对话式智能体搭建,包含以下技术点:
⻆⾊扮演提示词编写技巧| 设定⻆⾊身份、语⽓⻛格、知识边界| 对话开场⽩设计| 提示词调试与迭代优化| 上下⽂窗⼝概念| 多轮对话记忆机制| 对话变量设置| 上下⽂⻓度管理策略| 发布到⾖包| 发布到⻜书| 发布为API接⼝| 发布为独⽴⽹⻚链接| 微信/钉钉等渠道集成
6. 知识库与RAG应⽤该部分主要学习知识库与RAG应⽤,包含以下技术点:
RAG(检索增强⽣成)原理| 知识库能解决的问题(突破知识截⽌限制、企业私有知识问答、降低幻觉)| 知识库搭建与配置| Bot绑定知识库
7. 插件与⼯具能⼒该部分主要学习插件与⼯具能⼒,包含以下技术点:
什么是插件| Coze插件商店| 内置官⽅插件(搜索、图⽚识别、链接读取等)| 第三⽅插件| 链接读取插件、搜索插件、代码执⾏插件、图⽚理解插件、代码执⾏插件与图⽚理解插件实战
8. ⼯作流WorkFlow该部分主要学习⼯作流WorkFlow,包含以下技术点:
什么是⼯作流| ⼯作流vs简单对话Bot的适⽤场景| 可视化编排节点介绍| 开始节点(输⼊定义)| 结束节点(输出设置)| ⼤模型节点(LLM调⽤)| 代码节点(Python/JS)| 条件判断节点| 变量聚合节点| 节点编排实操
9. Coze智能体项⽬该部分主要学习Coze智能体项⽬,包含以下技术点:
智能体项⽬需求分析| Bot架构设计| 分模块开发| 联调测试| 最终发布上线| 多端适配验证| ⽤户反馈收集| 后续迭代计划
10. VibeCoding理念与准备该部分主要学习VibeCoding理念与准备,包含以下技术点:
Vibe Coding是什么| AI编程⼯具链| Claude Code安装与配置
11. Vibe Coding零代码开发智慧医疗智能体该部分主要学习Vibe Coding零代码开发智慧医疗智能体,包含以下技术点:
医疗问诊智能体项⽬定位| 需求分析| 技术架构与项⽬数据流转| 项⽬结构搭建| ⼤模型接⼊| 问诊业务逻辑| 知识库服务| ⽇志与监控| 异常处理体系| 前端交互开发| 基于Vue打造前端Web界⾯| 前后端联调| 功能测试| 安全测试| 体验测试| 部署⽅案选型| 项⽬总结与展示
12. Coze智能体与Vibe Coding项⽬实战该部分主要学习Coze智能体与Vibe Coding项⽬实战,包含以下技术点:
⼩组分配| 任务说明| 任务划分| ⼩组基于Coze开发智能体| 搭建WEB⻚⾯| Vibe Coding零代码开发⼩游戏| 项⽬答辩
13. ⼤模型必备Python基础掌握大模型必备Python基础语法,包含了以下技术点:
学习⼤模型必备Python语⾔| Python解释器和Pycharm开发⼯具安装| 注释和变量| 标识符和关键字以及命名规范| 输⼊和输出函数| 算数运算,⽐较运算,逻辑运算,赋值运算
14. ⼤模型必备Python流程语句掌握大模型必备Python流程语句,包含了以下技术点:
Python的三⼤流程控制语句| if选择结构,while/for循环结构| pass占位语句| 循环嵌套中的break/continue| 双重for循环执⾏流程| 99乘法表案例| 图形打印案例(三⻆形、菱形等)| 循环嵌套性能注意事项| 猜数字游戏开发、⽤户登录验证、带menu菜单程序设计实战
课时:10天 技术点:80项 测验:1次 学习方式:线下面授
掌握面向对象编程思想| 独立运用面向对象思想完成指定需求| 掌握深拷贝和浅拷贝代码原理| 独立完成面向对象版-学生管理系统| 掌握闭包, 装饰器的用法| 独立完成网编案例代码实现| 掌握多进程, 多线程相关代码实现| 掌握上下文管理器对象的使用| 掌握生成器, 迭代器的用法| 理解正则表达式的相关运用| 掌握MySQL基本操作| 掌握Pandas基本操作
1. ⼤模型必备Python容器掌握大模型必备Python容器,包含了以下技术点:
容器的概念与⽤途| Python内置容器类型:str/list/tuple/set/dict| 可变容器 vs 不可变容器| 容器选择决策| 索引与切⽚操作
2. ⼤模型必备Python函数掌握大模型必备Python函数,包含了以下技术点:
函数⼊⻔| 函数定义和调⽤| 函数的参数和返回值| 变量作⽤域| 函数的多种参数| 拆包和变量交换| Lambda表达式
3. ⼤模型必备Python⽂件和异常处理掌握大模型必备Python文件和异常处理,包含了以下技术点:
⽂件的读写⼊⻔| 中⽂乱码和路径问题| ⽂件复制| os模块| with-open语法| 异常处理⽅式| 导⼊包和模块
4. ⾯向对象从逐步建立起面向对象编程思想,再到会使用对象,到创建对象,再到真正理解为什么封装对象。包含了以下技术点:
⾯向对象和⾯向过程| 类和对象的区别| 定义类和属性| 定义⽅法和魔法⽅法| ⾯向对象-案例| 【实战案例】⾯向对象综合实战案例| 继承的使⽤| 私有权限| 类属性和对象属性| 类⽅法和静态⽅法| ⾯向对象版-学⽣管理系统| 【实战作业】⾯向对象版-学⽣管理系统(采取部分实战)
5. Python⾼阶语法主要学习Python高阶语法,包含了以下技术点:
深拷⻉, 浅拷⻉详解| 闭包详解| 装饰器详解| 【实战案例】装饰器实战案例| ⽹编相关概述介绍| ⽹编案例-客户端发送⽂件到服务器端| 并⾏和并发详解| 多进程-代码实现| 【实战案例】⽹编案例-客户端和服务器端交互| 多线程代码实现| 守护线程详解| 互斥锁详解| 线程同步详解| 上下⽂管理器详解| Json数据⽂件读取和处理| 【实战案例】Json数据⽂件读取和处理| ⽣成器详解| 协程详解| 迭代器详解| 正则表达式详解| 【实战案例】正则表达式⽂本匹配综合案例
6. SQL数据库主要学习MySQL数据库的核心知识,包含了以下技术点:
数据库基本操作| 数据库概念和作⽤| 关系型数据库和⾮关系型数据库| MySQL数据类型| 数据完整性和约束| 数据库创建| 表操作命令| 表数据操作命令| where⼦句| 分组聚合| 连接查询| 外键的使⽤| PyMySQL安装和使⽤| sql注⼊| 【实战案例】 ⽤户登录系统| Redis安装| 字符串 (String) 缓存| 哈希 (Hash)存储对象| 列表 (List)消息队列| 有序集合 (ZSet)排⾏榜等
7. Pandas主要学习Pandas核心知识,包含以下技术点:
Numpy基础概念与操作| 运算优势| 数组的属性| 数组的索引| 数组的形状| 数组的运算| 数组的⼴播机制等| Pandas统计分析| Pandas数据整理| Pandas透视表| Pandas+Matplotlib可视化(直⽅图/散点图/柱状图/折线图/饼图)| 【实战案例】中美⽇GDP数据折线图制作
课时:2天技术点:20项测验:1次学习方式:线下面授
能够理解和应⽤提示词⼯程原理| 掌握优化技巧并完成⾦融业务场景的实际问题解决
基于Zero-shot零样本学习能⼒,通过DeepSeek/QWen/ChatGLM模型对⾦融领域数据进⾏分类、信息抽取、⽂本匹配,更好的解决业务问题
提示词撰写解决方案| 文本分类提示词解决方案| 信息抽取提示词解决方案| 文本匹配提示词解决方案
⼤模型发展过程| 提示词介绍及撰写介绍| 提示词优化⽅法| 基于Ollama模型部署完成提示词⼯程案例| 什么是Prompt Engineering| Prompt Engineering的原理以及实际应用的优化技巧| 如何利用Prompt Engineering完成实际金融业务
课时:6天学习方式:线下面授
基于Coze的智能⾯试助⼿项⽬(⾯试通)
基于Dify的电商智能分析项⽬(数智通)
基于Coze⼯作流平台,结合LLM、ASR、TTS、RAG等技术,为⿊⻢程序员AI学科学⽣构建⾯试全流程智能辅助系统,实现简历修改、⾯试录⾳分析、个性化⾯试题⽣成和实时语⾳模拟⾯试等功能
能够掌握Coze智能体开发范式 | 能够独⽴完成多场景智能体应⽤的构建与部署 | 能够实现⼯作流⾃动化与业务赋能
实现基于插件完成PDF、DOCX等⽂档转⽂本到分析处理的全流程解决⽅案 | 实现基于ASR技术实现录⾳⽂件转⽂本到分析处理的全流程解决⽅案 | 实现基于知识库结合PDF实现精准内容⽣成的解决⽅案 | 实现在⼯作流中读写数据库和知识库的解决⽅案 | 实现⽗⼦模式多Agent架构⾃主规划执⾏解决⽅案
简历修改:基于OCR插件、prompt、数据库查询,实现简历中各类常⻅问题的召回和修改建议,以及进阶功能:违禁词过滤、业务背景重复率统计等,辅助学⽣编写更好的简历 | ⾯试录⾳分析:基于多模态⼤模型实现ASR,基于prompt实现⾯试官、应试者⻆⾊划分,最终实现⽂字提取、摘要以及建议,提⾯试⾼录⾳分析的效率 | ⾯试题⽣成:基于⿊⻢⾯试宝典使⽤RAG技术结合学⽣的简历,结合简历上的技能点、业务背景、毕业时间、专业等信息,⽣成个性化的⾯试题题库 | 模拟⾯试:基于简历和⾯试题⽣成流⽔线等功能,基于邢⽼师⾳⾊克隆⾯试官⾳⾊,结合ASR模型、TTS模型等技术,实现实时语⾳⾯试
本项⽬针对电商业务中数据分散(数据库)、规则分散(⽂档)、系统割裂(BI/知识库/AI⼯具)以及业务⼈员不会SQL、不会分析数据等痛点,基于Dify构建⼀套电商AI智能分析系统,通过融合⼤模型(LLM)、RAG检索和数据库分析能⼒,实现“⾃然语⾔提问 → ⾃动查询数据/知识 → 智能分析 → 图表展示”的⼀体化闭环,显著降低数据分析⻔槛,提⾼数据利⽤效率和业务决策能⼒
理解AI数据分析系统从“模型调⽤”到“系统设计”的完整流程 | 掌握Dify平台核⼼能⼒(RAG/Agent/Workflow)及应⽤开发掌握⾃然语⾔转SQL的数据分析实现⽅案 | 掌握RAG知识库构建流程(分段/Embedding/检索/⽣成)掌握多节点⼯作流编排(判断/分⽀/循环/组合) | 掌握数据分析结果⾃动解释与可视化实现 | 具备AI系统整合能⼒(数据库 + 知识库 + ⼤模型 + ⼯作流)
数据查询问题:通过LLM⾃动⽣成SQL,实现“不会SQL也能查数据” | 知识分散问题:构建RAG知识库,实现统⼀语义检索与问答 | 系统割裂问题:通过Dify⼯作流整合数据分析、知识问答与AI能⼒ | 分析能⼒不⾜问题:LLM⾃动对查询结果进⾏总结与解释 | 可视化困难问题:⾃动⽣成图表(趋势/对⽐/占⽐)辅助决策 | 复杂任务不稳定问题:通过Workflow拆解任务,提⾼系统可控性与稳定性 | 整体⽅案:构建“查询 + 检索 + 分析 + 可视化”的AI闭环系统
Dify平台:模型管理、⼯作流编排、应⽤发布 | Prompt⼯程:提示词设计、约束控制、结构化输出(JSON) | RAG技术:⽂档分段、Embedding、向量检索、混合检索、重排 | 数据库与SQL:MySQL结构设计、⾃然语⾔转SQL、查询优化 | ⼯作流设计:多节点流程、分⽀判断、循环控制、代码节点 | ⼤模型应⽤:LLM问答、数据分析解释、结果⽣成 | 数据可视化:ECharts图表⽣成(折线图/柱状图/饼图) | 系统⼯程:AI应⽤架构设计、多模块集成、业务落地能⼒
课时:13天 技术点:100项 测验:1次 学习方式:线下面授
掌握AI/ML/DL基本概念及数据、算法、算力协同| 能处理数据(特征标签划分、归一化标准化)、诊断欠/过拟合、用交叉验证和网格搜索调参| 熟悉KNN、线性回归、决策树、Bagging与Boosting、随机森林、聚类及评估| 具备PyTorch实操:张量与自动微分、搭建全连接网络(激活函数、损失函数、优化器、正则化)、设计CNN(卷积池化步长填充)做图像分类、用RNN处理文本(词嵌入、文本生成)| 理解词向量与Transformer(自注意力、位置编码),会用BERT做文本分类、相似度等下游任务| 了解常见BERT变体| 能独立完成预训练模型微调| 具备NLP应用搭建能力
1. 机器学习概述该部分主要学习机器学习基础,包含以下技术点:
⼈⼯智能(AI)| 机器学习(ML)| 深度学习(DL)| 三者关系| 基于规则的学习与基于模型的学习的区别| 数据| 算法| 算⼒| CPU、GPU、TPU的特点| 样本| 特征| 标签| 训练集| 测试集| 有监督学习(回归/分类)| ⽆监督学习(聚类)| 半监督学习| 强化学习
2. 机器学习的主要步骤该部分主要学习机器学习的主要步骤,包含以下技术点:
获取数据| 数据基本处理| 特征⼯程| 模型训练| 模型评估| 上线服务| 特征提取| 特征预处理| 特征降维| 特征组合| ⽋拟合、过拟合的概念及产⽣原因| 泛化能⼒与奥卡姆剃⼑原则| KNN算法的核⼼思想| 交叉验证与⽹格搜索(GridSearchCV)| 混淆矩阵、精确率、召回率、F1-score
3. 经典机器学习算法该部分主要学习经典机器学习算法,包含以下技术点:
线性回归模型|损失函数(MSE)| 正规⽅程法与梯度下降法(全梯度/随机梯度/⼩批量梯度/SAG)| 评价指标:MAE、MSE、RMSE| L1正则化(Lasso回归)| L2正则化(岭回归)| 决策树(CART)的分类与回归原理| 决策树剪枝(预剪枝/后剪枝)| 集成学习思想| Bagging(随机森林)| Boosting(AdaBoost/GBDT/XGBoost等)| 随机森林的构建⽅法| 聚类算法(⽆监督学习)概念| 常⽤⽅法(K-Means/层次聚类/DBSCAN等)| K-Means算法实现流程| 聚类评估——SSE(误差平⽅和)、肘⽅法
4. 深度学习架构该部分主要学习深度学习架构,包含以下技术点:
深度学习概念| 深度学习发展史| 与机器学习的关系| 神经⽹络结构| 神经元构成| 输⼊层| 隐藏层| 输出层| 参数初始化⽅法| 激活函数| Sigmoid| tanh| ReLU| SoftMax
5. 神经⽹络优化⽅法该部分主要学习神经⽹络优化⽅法,包含以下技术点:
损失函数| 交叉熵| MAE| MSE| smoothL1| 优化算法| SGD(随机梯度下降)| Momentum(动量)| Adam(⾃适应矩估计)| 学习率衰减与正则化| 学习率衰减| Dropout(随机失活)| BN(批归⼀化)
6. 经典⽹络架构该部分主要学习经典⽹络架构,包含以下技术点:
卷积神经⽹络| 卷积层| 池化层| 特征图计算| 完成CIFAR-10图像分类| 循环神经⽹络| 词嵌⼊| RNN原理| 周杰伦歌词⽣成任
7. Pytorch框架该部分主要学习Pytorch框架,包含以下技术点:
Pytorch安装与环境配置| 张量的概念| 张量的创建| 类型转换| 数值计算| 索引操作| 形状变换| 张量的拼接| ⾃动微分| Pytorch构建神经⽹络| Pytorch案例实战
8. NLP⼊⻔该部分主要学习NLP⼊⻔核心技术,包含以下技术点:
什么是⾃然语⾔处理NLP| ⾃然语⾔处理NLP的发展史| ⾃然语⾔处理应⽤场景| 什么是⽂本预处理| ⽂本处理的基本⽅法| ⽂本张量的表示⽅法| ⽂本数据分析| ⽂本特征处理
9. RNN及其变体该部分主要学习RNN及其变体,包含以下技术点:
什么是RNN| RNN模型作⽤及类别| 传统RNN| LSTM| GRU
10. Transformer该部分主要学习Transformer,包含以下技术点:
什么是transformer| transformer的作⽤| transformer模型架构| transformer优势
11. 迁移学习该部分主要学习迁移学习,包含以下技术点:
Fasttext| 迁移学习| NLP中常⽤预训练模型| Transformers库的使⽤
课时:7天技术点:100项测验:1次学习方式:线下面授
基于⼤规模业务留存数据构建快速⽂本分类系统| 快速搭建短⽂本精准分类模型| 基于随机森林和FastText搭建快速基线模型, 验证业务通道的能⼒基于BERT的迁移学习优化模型搭建的能⼒| 实现神经⽹络量化的优化与测试| 实现神经⽹络剪枝的优化与测试| 实现神经⽹络知识蒸馏的优化与测试| 更多主流预训练模型的优化与深度模型剖析| BERT模型在⽣成式任务和⼯程优化上的深⼊扩展
NewsCompass投满分项⽬是结合今⽇头条真实场景下的海量数据, 快速搭建随机森林和FastText的基线模型, 以验证商业化落地的可⾏性. 更多聚焦在深度学习的优化⽅法上, 搭建基于BERT的初版微调模型, 应⽤量化,剪枝,预训练模型微调,知识蒸馏等多种⼿段,反复迭代,反复优化模型的离线效果,在线效果
海量⽂本快速分类基线模型解决| ⽅案基于预训练模型优化的解决⽅案| 模型量化优化的解决⽅案| 模型剪枝优化的解决⽅案| 模型知识蒸馏优化的解决⽅案| 主流迁移学习模型微调优化的解决⽅案
随机森林(集成学习)| 基线模型(FastText)| BERT优化| 模型量化、剪枝、知识蒸馏| 基于大模型文本分类
课时:1天 技术点:50项 测验:1次 学习方式:线下面授
理解LangChain框架的定位和基本概念| 掌握LangChain框架models、chain、prompt、indexes| 掌握LangChain框架记忆的使⽤
1. ⼤模型模型层Models该部分主要学习⼤模型模型层Models,包含以下技术点:
LLM 基类:输⼊⽂本输出⽂本,传统⼤模型调⽤接⼝封装| ChatModel聊天模型:消息结构(System/Human/AI Message),对话格式封装| 模型集成:OpenAI、通义千问、本地开源模型 (Ollama/LlamaCpp)| 模型参数配置:temperature、top_p、max_tokens、stop词、流式输出stream| Embedding接⼝:⽂本向量化,⽂档Embedding、查询Embedding区别| 开源/闭源 Embedding 模型接⼊| 批量⽂本嵌⼊、⽂本分⽚后向量化| 向量维度、相似度计算(余弦相似度)
2. 提示词⼯程层Prompts该部分主要学习提示词⼯程层Prompts,包含以下技术点:
基础 PromptTemplate:变量占位符`{变量}`,字符串模板渲染| ChatPromptTemplate:多⻆⾊消息模板组合 (System/Human/AI)| Partial 局部变量预填充| from_messages 快速构建聊天模板| FewShotPromptTemplate 少样本模板| Example 样本示例| BaseOutputParser 基类,解析⼤模型返回⽂本| PydanticOutputParser:结构化输出 JSON,绑定数据模型| JsonOutputParser、CommaSeparatedListOutputParser| 格式化提示词注⼊,告诉模型输出格式
3. ⼯具与智能代理Agents (⾃主调⽤⼯具)该部分主要学习⼯具与智能代理Agents,包含以下技术点:
BaseTool ⼯具基类:name、description、_run 执⾏逻辑| 内置⼯具:搜索⼯具、计算器、PythonREPL 代码执⾏| ⾃定义⼯具 @tool 装饰器快速定义| Agent核⼼逻辑:思考(Thought)→⾏动(Action)→观察(Observation) ReAct框架| ReAct Agent、OpenAI Function Calling Agent| AgentExecutor代理执⾏器,循环执⾏思考调⽤⼯具| ⼯具选择、⼯具错误处理
课时:8天学习方式:线下面授
基于职业教育领域RAG智慧问答系统项目
基于人力资源场景的RAG简历推荐系统项目
企业级标准RAG解决⽅案。基于IT职业教育⾏业答疑⼤模型抽取RAG解决⽅案,通过项⽬学习完成企业级RAG系统完整流程搭建与测试及优化。从智能查询路由设计、数据处理与多源集成、模型微调到后端服务与前端开发以及Docker企业级部署,完成全栈RAG系统构建
了解LangChain基本概念、明确LangChain主要组件的作⽤、了解LangChain常⻅的使⽤场景 | 掌握基于LangChain+ChatGLM-6B模型实现本地知识库的问答实现原理+过程| RAG系统开发与优化:掌握从数据分⽚到答案⽣成的RAG全流程,熟练应⽤ HyDE、⼦查询等检索增强策略提升系统性能 | ⼤模型应⽤实践:能够集成LLM(如 OllamaLLM)并设计⾼效Prompt,解决知识问答中的业务定制化需求 | 智能查询路由设计:实现规则、相似度和LLM三层路由,精准分发查询并优化复杂意图识别效率 | 后端服务与前端开发:使⽤FastAPI开发⾼并发API并通过Gradio构建交互界⾯,满⾜企业级服务与⽤户体验要求 | 数据处理与多源集成:熟练处理结构化与⾮结构化数据,结合MySQL和向量搜索打造⾼效知识检索系统 | 企业级问题解决能⼒:通过⽇志调试和⾼并发设计,具备定制化开发与性能优化的实战技能,适配智能客服等场景
数据库查询优化:BM25 + Redis 缓存解决方案 | 语义检索:Milvus 混合向量检索解决方案 | 查询分类:BERT 分类器解决方案 | 动态检索策略:LLM 驱动的策略选择解决方案 | 答案生成:LLM + RAG 提示模板解决方案 | 性能优化:Redis 缓存 + 模块化设计解决方案 | 日志与监控:统一日志系统(logging)解决方案 | 配置管理:ConfigParser + config.ini解决方案
智能问答系统架构:FAQ系统与RAG系统的区别与应⽤场景 | 数据库技术:MySQL表查询;Redis键值存储与缓存机制;Milvus向量数据库的架构与索引类型 | 检索算法:BM25算法原理;密集向量&稀疏向量混合检索;重排序的作⽤ | query的意图识别+改写:BERT分类器的训练与推理;LLM的调⽤与提示设计;查询分类与动态检索策略的实现逻辑 | 企业级开发实践:模块化代码设计与代码复⽤;配置⽂件(config.ini)与环境变量管理;⽇志系统设计与错误处理
项⽬基于向量数据库和LLM构建⼀个端到端、可⽔平扩展的检索增强⽣成(RAG)系统,⽀持对异构简历(PDF/DOCX/JPG/PNG)进⾏⾃动解析、结构化、语义索引与多轮对话式推荐。系统以向量数据库为核⼼存储,以LLM为推理中枢,以Agent框架为调度单元,⾯向企业HR及猎头平台提供秒级、可追溯、可解释的候选⼈推荐服务
掌握⽂档智能处理、向量化索引、RAG系统开发掌握Agent框架应⽤ | 能够完成可扩展的简历推荐系统部署
基于LangChain+OpenAI实现异构简历(PDF/DOCX/JPG/PNG)智能解析与结构化提取 | 使⽤Milvus+BGEM3混合嵌⼊+ElasticSearch实现⾼级向量索引与多路召回 | 构建⽀持参数过滤、查询重写与历史对话的异步RAG链⽣成JSON候选⼈推荐 | 基于SmartRecruitAgent框架实现意图识别、多轮追问与上下⽂候选⼈筛选的智能代理集成Streamlit前端与Milvus/MongoDB/Elasticsearch多数据库持久化的DevOps配置 | 使⽤Ragas框架对RAG系统进⾏端到端Faithfulness/Answer Relevancy/Context Precision评估优化
配置管理与项⽬初始化:使⽤Pydantic统⼀管理系统参数(数据库、模型路径、切块参数等),避免硬编码,确保全局配置安全可验证 | ⽂档处理与切块:实现多格式简历加载、⽂件哈希去重、LLM结构化信息提取(姓名、性别、年龄、⼯作年限)以及⽗块-⼦块分层切分,⽀持图⽚OCR提取|向量存储与混合检索:基于Milvus(稠密+稀疏向量)+Elasticsearch(BM25全⽂搜索+MongoDB(元数据存储),结合CrossEncoder重排序和doc_hash去重,实现⾼效混合检索与过滤 | RAG链构建与⽣成:使⽤LangChain构建异步查询改写、检索上下⽂格式化与LLM⽣成链,⽀持结构化JSON推荐输出 | 智能Agent意图优化:实现意图识别、招聘参数提取、追问处理与对话历史管理,路由不同场景(招聘需求、闲聊、追问等) | Web应⽤与数据初始化:基于Streamlit开发聊天交互、简历上传、候选⼈卡⽚展示与在线查看功能,实现端到端⽤户体验
课时:1天 技术点:30项 测验:0次 学习方式:线下面授
使⽤LangGraph设计并实现具备状态管理、条件分⽀、并⾏执⾏、断点恢复的复杂AI ⼯作流| 理解并应⽤Reducer机制解决并⾏节点状态冲突问题| 区分条件边与Command的适⽤场景,并能根据需求灵活选择| 独⽴部署并配置LangFuse本地服务,为AI Agent接⼊链路追踪| 通过LangFuse控制台分析Agent执⾏过程,定位性能瓶颈、Prompt问题、检索错误或 Token消耗异常| 在团队项⽬中集成LangFuse回调,实现⽣产级可观测性,提升AI应⽤的调试与优化效率
1. LangGraph框架该部分主要学习LangGraph框架核心知识,包含以下技术点:
理解Graph(⼯作流框架)| State(状态容器,TypedDict定义)| Node (执⾏单元,函数接收State返回更新)| Edge(连接与流向,含普通边和条件边)| Checkpoint(检查点持久化)| 使⽤Annotated类型标注字段的更新策略(如add_messages⽤于消息列表追加,operator.add⽤于数值累加),解决并⾏节点并发更新同⼀字段的冲突问题| 掌握StateGraph类的使⽤,通过add_node添加节点函数, add_edge(START, node)和add_edge(node, END)定义流转, add_conditional_edges绑定路由函数与路径映射表,实现动态分⽀| 节点直接返回Command(goto="node_name") 动态指定下⼀步,⽀持并⾏执⾏多个节点(goto传⼊列表),相⽐条件边更灵活,适合复杂动态流程| 使⽤SqliteSaver(或MemorySaver)作为checkpointer,通过thread_id区分会话,invoke时传⼊config⾃动保存状态,⽀持中断后恢复执⾏| 状态聚合:多个节点更新同⼀字段时通过Reducer合并| 分⽀并⾏:⼀个节点连接多个后继节点,LangGraph⾃动并⾏执⾏| 分⽀节点数量不同的并⾏处理:通过将多个前驱节点指向同⼀后继节点(add_edge(["B2", "C"], "D"))实现等待合并| 条件并⾏:add_conditional_edges配合返回列表的路由函数,动态决定并⾏执⾏哪些节点
2. Langfuse框架该部分主要学习Langfuse框架核心知识,包含以下技术点:
Trace(⼀次完整Agent执⾏)| Span(执⾏中的每个步骤,如节点调⽤、 LLM请求)| Session(同⼀会话的多条Trace归组)、User(按学员ID过滤)| 通过Docker启动LangFuse服务(端⼝3001),⾸次使⽤需注册本地账号并⽣成API Key(Public Key+Secret Key),在.env.local中配置 LANGFUSE_PUBLIC_KEY、LANGFUSE_SECRET_KEY、LANGFUSE_HOST| 使⽤langfuse.callback.CallbackHandler创建Handler,通过LangChain的Callback机制注⼊config["callbacks"],LangGraph的ainvoke⾃动追踪每个节点的输⼊、输出、耗时、Token消耗
课时:8天学习方式:线下面授
EduAgent多智能体项⽬
星通通⽤智能体项⽬
基于LangChain、LangGraph和FastAPI构建。系统提供智能问答、代码审查、个性化学习路径规划和职业咨询等核⼼功能,旨在为在线教育场景提供全⽅位的AI辅助教学解决⽅案
基础设施:⼀键docker-compose启动全环境,PostgreSQL、Milvus、Redis、MinIO、 Judge0 全部就绪 | 公共能⼒层:LLM Factory多模型路由、BGE-Reranker精排、MiniLM意图分类,全部可独⽴调⽤ | 四⼤Agent:智能问答、试卷批改、简历审查、模拟⾯试,端到端流程完整跑通,异常处理与降级策略覆盖到位 | 前端集成:Vue3界⾯与后端API全⾯对接,SSE流式输出流畅,三级⻆⾊权限路由隔离完整 | 集成测试:核⼼流程覆盖率达标,三层兜底降级机制验证通过,并发压测⽆崩溃
教育场景多租户数据隔离解决⽅案:所有PostgreSQL表预埋tenant_id,Milvus Collection按租户namespace隔离,⽀持多班级、多课程独⽴运营 | ⾼精度RAG冷启动与持续迭代解决⽅案:初始知识库由课程资料清洗⼊库,检索链路采⽤混合召回+精排+置信度过滤,低置信度问答⾃动进⼊补充队列,教师在线添加后热更新知识库 | 复杂批改任务的三轨并⾏加速解决⽅案:试卷批改Agent中,客观题规则引擎、简答题LLM分组并⾏、代码题Judge0执⾏+LLM评估三条轨道通过asyncio.gather并发执⾏,整体批改耗时降低60%以上 | Human-in-the-Loop教师确认解决⽅案:利⽤LangGraph的interrupt()挂起批改结果,教师登录后逐题确认或修改,通过Command恢复图执⾏,并集成企业微信机器⼈⾃动推送待确认通知 | 国产模型低成本切换与降级解决⽅案:LLM Factory封装DeepSeek-V3(通⽤)和 DeepSeek-Coder-V2(代码),⽀持配置热切换;三层兜底机制(重试→降级模型→预设回复)保障LLM服务异常时的系统可⽤性 | 本地开发到⽣产环境的平滑迁移解决⽅案:本地使⽤DockerCompose + MemorySaver+MinIO,⽣产环境仅需修改配置(AsyncPostgresSaver、阿⾥云 RDS/OSS、K8s 部署),业务代码零改动,⽀持⼀键迁移
系统架构设计:理解EduAgent的五层架构(前端→API⽹关→Orchestrator→Agent执⾏层→公共能⼒层→MCP→数据存储),掌握分层职责与数据流向 | 四⼤Agent状态机实现:分别构建智能问答(RAG+多轮记忆)、试卷批改(三轨并⾏ + HitL)、简历审查(六维度并⾏)、模拟⾯试(四阶段状态机),熟练使⽤LangGraph的StateGraph、节点、边、并⾏发送(Send)等核⼼API | 意图识别与动态路由:基于MiniLM分类器+LLM 兜底实现请求分级(单Agent直达/多Agent串联/澄清对话),通过LangGraph条件边动态编排执⾏链路 | 公共能⼒层封装:实现LLM Factory(DeepSeek-V3/Coder-V2切换)、BGE-Reranker进程内精排、Milvus分层知识库检索、对话记忆(MemorySaver/AsyncPostgresSaver)等共享组件 | MCP⼯具统⼀接⼊:理解MCP协议,实现知识库检索、代码沙箱(Judge0)、数据库操作、⽂件解析、外部搜索等MCP Server,并在LangGraph Agent中通过MCP Client 标准化调⽤ | 教师端Human-in-the-Loop:使⽤LangGraph的interrupt()和Command实现试卷批改的教师确认节点,⽀持暂停、修改、恢复,并集成企业微信通知
通⽤智能体作为该领域的⾼阶形态,其开发能⼒可为各类垂直场景的智能体构建提供坚实基础与技术范式。本项⽬基于Langchain 1.0框架,集成了MCP协议、多模态处理及联⽹搜索等前沿技术,是理解和构建复杂智能体平台的实战标杆。项⽬旨在构建⼀个基于LangChain⽣态的通⽤Agent平台,实现⾃主任务规划、多模态交互及联⽹搜索功能,⽀持多⽤户并发,具备极强的扩展性
构建智能代理中枢:实现⼯具调⽤、⾃主任务规划及深度上下⽂理解 | 实现全模态覆盖:⽀持主流办公⽂档(PDF/Word/Excel/PPT)及图⽚的双向处理 | 集成实时信息检索:通过Tavily API实现联⽹搜索,确保信息的时效性与准确性 | 提供企业级架构:⽀持多⽤户、多会话,提供完善的监控与追踪能⼒
基于Langchain DeepAgents,完善⽂件管理与任务规划 | 通过⽣图模型与VLM增加图⽂能⼒ | 通过若⼲MCP扩展Agent能⼒ | 通过Skill-creator与⽂件管理增加制作Skill并⽴即⽣效的能⼒ | 通过Docker完善项⽬部署
LangChain1.0:核⼼基座,整个项⽬是⼀个Langchain1.0框架下的⼯程,提供项⽬架构,Agent基座,中间件编排,⼦Agent编排等 | LangSmith:可视化观测⽇志与调试项⽬,使Agent可在⾼效的体系下调试 | Tavily Search:联⽹搜索集成,使Agent可获取实时信息 | SiliconFlow API:多模型服务接⼊,提供了LLM、VLM及图像⽣成能⼒的统⼀接⼊,且有免费额度,因此该项⽬得以在基于免费资源开发 | MinIO:对象存储,通过对象存储,传递Agent制作的⽂件给⽤户 | Agent Chat UI:开箱即⽤的前端界⾯,与LangChain⼯程⽆缝衔接,使得Agent可以有⼀个直观的可视化界⾯ | Docker:项⽬整合与部署,整合⼯程与数据库依赖,使项⽬最终可以⼀键部署 | MCP:连接外部⼯具,连接了Excel-mcp,Tavily Search,ppt-mcp等⼯具,丰富Agent的能⼒ | PostgreSQL:关系型数据库,存储历史对话与状态信息等LangChain⽣产级⼯程指定数据库, 现有协议使得开发⾼效
课时:6天学习方式:线下面授
中医知识图谱Agent项⽬
智能旅游多Agent项⽬
SmartCloud云服务系统
“草本通” 项⽬致⼒于解决中医药知识难以理解、碎⽚化严重、检索效率低 等问题,通过爬⾍、DeepSeek+LangChain实体抽取、Neo4j图谱构建与LangGraph多智能体协同,打造⼀个可理解、可对话、可传播、可拓展的智能知识服务平台。系统融合多种AI技术,⽀持从数据采集到语义问答、图谱构建、再到内容⽣成与平台发布的完整AI闭环
掌握知识图谱构建、多智能体流程调度 | 掌握⽣成式应⽤开发 | 能够具备垂直领域知识智能化平台的搭建能⼒
多源中医药数据爬取与联合任务数据预处理适配知识图谱构建的解决⽅案 | 基于Neo4j + FAISS的中医药知识图谱检索增强(RAG)解决⽅案 | 基于LangGraph的中医药智能问答与多意图⼯作流编排解决⽅案 | 基于FastAPI实现LangGraph智能体流式API接⼝开发的解决⽅案 | 基于LlamaFactory微调⼤模型进⾏实体关系⽣成的解决⽅案
利⽤爬⾍⾃动采集中药、⽅剂、功效、症状、疾病等原始⽂本 | 使⽤⼤语⾔模型(DeepSeek)+ LangChain进⾏实体与关系抽取 | 构建Neo4j图数据库与 Faiss 向量检索双引擎,实现结构化查询与语义匹配 | 基于LangGraph搭建多智能体协同系统,管理复杂问答流程 | 提供基于Streamlit的⽹⻚端交互式问答界⾯ | ⾃动⽣成小红书⻛格图⽂内容,并实现⼀键发布,实现从“知识获取”到“内容传播”的闭环
SmartVoyage是⼀个智能旅⾏助⼿系统,使⽤A2A(Agent-to-Agent)协议构建多代理协作框架,⽀持⽤户查询天⽓和票务信息。系统包括LLM路由服务器(意图识别)、天⽓代理服务器(查询天⽓数据库)、票务代理服务器(查询票务数据库)、MCP⼯具服务器(数据库接⼝)、数据采集脚本和前端客户端。⽤户输⼊查询(如“北京天⽓”或 “北京到上海⽕⻋票”),系统通过LLM路由到合适代理,代理⽣成SQL查询MCP数据库,返回结果显示在界⾯
能够掌握A2A多代理框架开发 | 掌握意图识别与数据库查询技能 | 能够完成交互式旅⾏助⼿系统的构建
基于Python-a2a协议实现多代理A2A协作框架 | 使⽤LangChain+DeepSeek构建LLM路由服务器意图识别与动态路由 | 实现MCP⼯具服务器标准化MySQL查询接⼝ | 天⽓代理服务器LangChain SQL⽣成与MCP实时天⽓数据库查询集成 | 票务代理服务器多类型动态SQL⽣成与结果友好格式化 | 基于Streamlit开发A2A多代理实时交互前端客户端
LLM 路由服务器(意图识别) | 天⽓代理服务器(查询天⽓数据库) | 票务代理服务器(查询票务数据库) | MCP⼯具服务器(数据库接⼝) | 数据采集脚本|Streamlit前端客户端
项⽬基于LangChain、LangGraph和FastMCP等⼯业级框架,实现了5个专业AI智能体的协同⼯作系统,覆盖云服务全⽣命周期⽀持。项⽬集成了意图识别、追问检测、分布式缓存、多模态处理及A2A跨系统协作等前沿技术,是理解和构建⽣产级AI应⽤的实战标杆
AI架构设计能⼒:掌握微服务架构下的AI系统设计,解耦⼤脑(Agent)与⼿脚(Tools) | RAG系统构建能⼒:精通Milvus+Elasticsearch混合检索架构,实现⾼精度知识问答Agent | 编排能⼒: 熟练使⽤LangGraph构建ReAct、Saga等复杂Agent模式 | 协议集成能⼒:掌握MCP(Anthropic)和A2A(Google)两⼤前沿协议,实现⼯具标准化与跨系统协作 | 意图识别优化能⼒:实现"规则引擎+⼩模型+⼤模型"的分级意图识别,平衡成本与体验 | 分布式事务处理能⼒: 在Agent系统中落地Saga模式,保障数据⼀致性 | 全链路监控能⼒:使⽤Phoenix和LangSmith进⾏LLM应⽤的调试、评测与监控 | 多模态应⽤开发能⼒:集成⽂⽣图、⽂⽣⽂⼯作流,打造全能型助⼿ | 全栈开发能⼒:独⽴完成从后端API到前端React交互的完整开发
基于Multi-Agent协作与Agentic RAG技术构建⼯业级云服务智能客服系统的解决⽅案 | 实现MCP+A2A协议的多智能体A2A协作框架的解决⽅案 | 使⽤LangChain+LangGraph构建LLM路由服务器意图识别与动态路由的解决⽅案 | 实现基于FastMCP协议标准化MySQL查询接⼝的⼯具服务器解决⽅案 | 基于RAG+MCP调⽤实现融合知识库与业务API的上下⽂增强解决⽅案 | 实现向量数据库(Milvus+BM25(Elasticsearch)双检索的知识库增强⽣成解决⽅案 | 实现动态更新知识库的RAG服务⾃动化迭代解决⽅案 | 实现双层级智能缓存(Redis L1+会话 L2)的⾼性能响应加速解决⽅案 | ⽀持Saga分布式事务保障的多数据库(MySQL+MongoDB)对话持久化⼀致性解决⽅案 | 集成Deep Research能⼒的⾃主调研与⾏业分析报告⾃动⽣成解决⽅案 | 实现系统级别(Prometheus+Grafana+cAdvisor)与业务级别(Phoenix+ LangSmith)全链路监控的智能运维解决⽅案
Orchestrator 路由服务器(意图识别与动态路由) | Product_Tech_Agent(产品技术咨询 Agent) | Finance_Order_Agent(财务账单查询 Agent) | ICP_Service_Agent(备案与合规服务 Agent) | Deep_Research_Agent(深度研究与报告⽣成 Agent) | Ops_Marketing_Agent(营销推⼴与内容⽣成 Agent) | MCP ⼯具服务器(Base Tools / RAG Tools / Dify Tools) | Agentic RAG服务(混合检索与知识增强) | A2A协议通信层(跨 Agent 协作) | 三级智能缓存与Saga分布式事务层 | 全链路监控与可观测性层(Phoenix + LangSmith + Grafana)
课时:6天学习方式:线下面授
从Vibe Coding到SDD规范驱动交付
HeiMaClaw系统级Agent
Hermes⾼阶实战
本课程以Claude Code+Trae+OpenClaw为核⼼⼯具链,系统构建从Vibe Coding到Agentic Engineering的⽣产级AI开发体系。学员通过standardsv2.0企业级⼯程化框架,完成两⼤真实业务项⽬:基于阿⾥云天池真实数据集的⾦融营销预测系统(端到端MLOps全流程);浏览器端⾼性能⽹⻚三消游戏(实时交互引擎)。全程落地GitHub Actions+Docker⽣产级CI/CD流⽔线,实现从意图定义到Multi-Agent协同开发、再到⾃动化安全交付的完整⼯业闭环
掌握Agentic Engineering⽅法论,成为智能体全栈Owner | 熟练使⽤Claude Code + Trae实现多智能体协同开发 | 精通standards v2.0框架,快速完成企业级项⽬⼯程化治理 | 完成⾦融场景端到端MLOps全流程(数据探索→模型训练→FastAPI⽣产部署) | 掌握浏览器端⾼性能实时交互系统开发能⼒ | 独⽴搭建GitHub Actions + Docker⽣产级CI/CD与容器化交付流⽔线 | 完成OpenClaw私有化多渠道Agent平台构建与⻜书集成
基于Claude Code + Trae的Agentic Engineering多智能体协同开发解决⽅案 | 基于standards v2.0框架的企业级AI项⽬⼯程化治理与⾃动化交付解决⽅案 | 基于Claude Code Agentic开发的⾦融营销预测端到端MLOps全流程解决⽅案 | 基于GitHub Actions + Docker的⽣产级CI/CD与容器化DevOps交付解决⽅案 | 基于OpenClaw的私有化多渠道Agent平台构建与⻜书集成解决⽅案
编程抽象演进与AI编程范式(Vibe Coding → Agentic Engineering) | AI编程工具链与Agent协同策略(Cursor、Claude Code、Trae、OpenClaw) | Agentic Engineering与多智能体协同开发 | 企业级AI项目工程化规范体系(standards v2.0框架) | 数据智能分析与机器学习全流程案例实战(银行营销预测系统) | 交互式Web前端与复杂游戏逻辑实现案例实战(网页三消乐) | 生产级CI/CD与容器化DevOps交付体系(GitHub Actions + Docker多阶段构建 + Secrets安全远程部署) | OpenClaw多渠道Agent平台实战
OpenClaw项⽬是真正的⽣产级开源AI Agent⽹关,远超“聊天机器⼈壳⼦”,其核⼼竞争⼒在于完整实现了Agent记忆能⼒(Memory+RAG)、系统物理交互(Sandbox Tools)、⾃迭代防死循环(tool-loop-detection+compaction)以及Multi-Agent协同(Subagent spawn) 项⽬采⽤Monorepo(pnpm-workspace)结构,TypeScript开发,内置Pi-embedded-runner原⼦执⾏引擎,⽀持Feishu、Slack、WhatsApp等⼗余个渠道⽆缝接⼊。通过LanceDB本地向量库+混合检索+时间衰减算法,实现真正可⽤的⻓期记忆;所有Tool执⾏均在Docker/Podman沙箱中完成,具备⽂件、⽹络、资源严格隔离;⽀持动态Subagent孵化,让复杂任务⾃动拆解;集成MCP协议实现标准化⼯具调⽤;⽣产部署⽀持systemd⾃启、Nginx⾼可⽤、Prometheus监控等企业级特性 该项⽬是理解和构建真实可⽤、⻓期运⾏、⽣产级AI Agent系统的实战标杆,特别适合希望掌握从消息接⼊到Agent 执⾏全链路、从开发到运维闭环的开发者
OpenClaw架构机制理解能⼒:理解OpenClaw整体架构机制,以及Gateway、Routing、 Agents执⾏、Memory RAG、Sandbox、Subagent等核⼼模块的协同⼯作原理 | ⻜书机器⼈配置与使⽤能⼒:熟练通过命令和配置⽂件快速接⼊并配置Feishu机器⼈,实现消息标准化接⼊与实际业务交互 | Skill查询安装与⾃定义扩展能⼒:学会通过ClawHub查询安装Skill,同时掌握⾃定义创建 Skill 包(SKILL.md+tools/+prompts/)扩展Agent能⼒
通过OpenClaw⼀键部署多消息渠道标准化接⼊并统⼀管理AI Agent的解决⽅案 | 通过OpenClaw ClawHub技能市场⼀键安装扩展Agent能⼒的解决⽅案 | 通过OpenClaw⾃定义创建并部署专属Skill包(SKILL.md+tools/+prompts/)扩展 Agent能⼒的解决⽅案 | 通过OpenClaw Sandbox安全执⾏Tool并彻底保障系统与数据安全的解决⽅案
Gateway 接收层(WebSocket + HTTP 统⼀⼊⼝与 Event Bus) | Multi-Channel 消息插件层(Feishu / Slack / WhatsApp / Discord 等适配器) | Routing 路由层(resolve-route.ts + 多租户 Session 隔离) | Agents 执⾏核⼼层(Pi-embedded-runner + Subagent 注册与孵化) | Memory ⻓期记忆与 RAG 增强层(LanceDB + hybrid 混合检索) | Context Engine 上下⽂引擎(静态 Workspace + 动态 Session + RAG 融合) | Hooks 扩展钩⼦系统(前置/后置消息处理) | Skills 插件化技能系统(ClawHub 市场 + SKILL.md 动态加载) | Sandbox 安全沙箱执⾏层(Podman/Docker 隔离)
HeiMaClaw×智新电池⼯⼚是⼀套⾯向制造业⼀线⽣产管理的企业级AI Agent落地⽅案。系统以HeiMaClaw⽣产级AI Agent平台为⼤脑,承担渠道接⼊、租户权限、Agent 编排、记忆审计和沙箱执⾏;以智新电池⼯⼚MCP Server为业务数据源,通过 FastMCP暴露产线状态、⼯单进度、班次产量三类业务⼯具,背后由独⽴数据库承载真实⽣产数据。两边通过MCP协议桥接,把远端⼯具统⼀注册为平台ToolRegistry中的标准⼯具,让班组⻓/⽣产主管在⻜书⾥⽤⾃然语⾔完成产线状态、⼯单进度、班次产量等真实业务查询,打通「⾃然语⾔⼊⼝→Agent 编排→MCP ⼯具→业务数据库→智能总结回复」的完整落地链路
掌握以HeiMaClaw为底座、以MCP业务服务器为数据源的「企业级Agent+业务系统」⼀体化落地能⼒ | 实现MCP⼯具的安全接⼊与⾃动注册 | 掌握MCP Server注册、 Agent可⻅性控制与权限策略联动 | 理解平台六层架构下业务数据「不进⼊平台、只⾛ MCP Tool」的设计边界 | 能够独⽴完成业务MCP Server构建、平台对接、⻜书⾃然语⾔⼊⼝验证,并基于审计、⻛险等级、租户作⽤域设计企业级安全闭环
基于FastMCP实现智新电池⼯⼚业务MCP Server并标准化暴露产线状态、⼯单进度、班次产量三类⼯具的解决⽅案 | 基于HeiMaClaw平台MCP可选依赖与桥接层实现远端⼯具⾃动安全注册到 ToolRegistry的解决⽅案 | 基于CLI命令完成MCP Server注册、Agent级可⻅性收敛及tools.allowed⽩名单联动的解决⽅案 | 基于AgentRunner + UnifiedExecutionEngine + Planner与LLM完成⾃然语⾔意图识别与槽位填充的解决⽅案 | 结合tool_gate与AuthPolicyManager实现租户隔离、权限策略下沉及企业级安全闭环的解决⽅案 | 构建“⻜书⾃然语⾔提问→HeiMaClaw Agent编排→安全MCP⼯具调⽤→业务数据库→智能总结回复”的企业级Agent+业务系统⼀体化落地闭环解决⽅案
业务MCP Server冷启动阶段,基于FastMCP框架实现电池⼯⼚业务⼯具开发,使⽤ SQLite承载产线、⼯单、班次三类真实⽣产数据,并通过SSE协议对外暴露标准业务⼯具 | HeiMaClaw平台接⼊阶段,安装MCP可选依赖,通过CLI命令完成业务服务器注册,并配置企业级元数据(传输⽅式、⻛险等级、租户作⽤域、超时等),再校验远端⼯具列表可达 | 实现MCP⼯具到ToolRegistry的安全桥接,通过桥接层⾃动拉取远端⼯具列表,采⽤安全命名规则⽣成本地⼯具名,并封装调⽤逻辑、归⼀化返回结果,同时携带权限元数据下沉到⼯具级别 | 实现意图识别与槽位填充,通过CLI把MCP Server启⽤到⽬标Agent,⾃动追加⼯具到⽩名单;运⾏时由Agent编排引擎把⾃然语⾔解析为标准⼯具调⽤,⼯具返回数据后再由LLM总结为业务话术 | 实现租户与权限闭环,每次⼯具调⽤携带租户、⽤户、⻆⾊等上下⽂,由权限策略管理器完成租户隔离与响应策略;⽀持全局开关与Agent级⼯具可⻅性动态收敛 | 实现⻜书渠道与⽣产部署闭环,完成⻜书⻓连接与回调接⼊,通过多进程启动⽅式,完成⽣产环境或智能体应⽤
课时:4天 技术点:70项 测验:1次 学习方式:线下面授
能够理解Transformer的注意⼒机制与架构设计,并掌握基于Transformer的翻译任务开发技能| 能够使⽤Hugging Face库对预训练模型进⾏全量微调,完成特定NLP任务| 能够理解主流⼤模型的架构特性与预训练原理,掌握为微调任务选择合适模型的能⼒
1. 大模型Transformer架构该模块主要学习大模型Transformer架构,包含以下技术点:
词向量(Word Embedding)| ⼤模型Transformer架构的注意⼒机制| ⼤模型Transformer架构(encoder、decoder、encoder+decoder)| ⼤模型Transformer翻译任务实战
2. 大模型迁移学习该部分主要学习大模型迁移学习,包含以下技术点:
迁移学习的预训练模型和微调阶段| NLP中的常⽤预训练模型(BERT/ GPT-1/GPT-2)| Hugging Face预训练模型仓库| Huggingface Transformers库使⽤(提供了NLP领域预训练语⾔模型结构模型和调⽤框架)| 基于微调⽅式实现中⽂分类、中⽂填空、句⼦关系等任务
3. 大模型主流模型运行机制该部分主要学习大模型主流模型运行机制,包含以下技术点:
GPT/DeepSeek/QWen基础| GPT/DeepSeek/QWen架构变化| GPT/DeepSeek/QWen的预训练任务| 基于DeepSeek/QWen预训练+微调任务实战
课时:4天技术点:80项测验:0次学习方式:线下面授
了解和掌握⼤语⾔模型的基本原理和架构,特别是ChatGLM-6B模型的结构和⼯作机制| 掌握⼤模型LoRA微调技术,通过微调预训练的⼤模型来适应特定任务的需求| 掌握⼤模型P-Tuning微调技术,对⼤模型进⾏⾼效的参数调整,增强其在特定任务上的表现| 能够掌握 QLoRA 量化微调与并⾏计算技术,完成⽂本摘要模型的⾼效训练与部署
项⽬以Qwen/DeepSeek模型为核⼼,通过LoRA和P-Tuning实现微博⽂本信息抽取+⽂本分类的多任务,通过⼀个⼤模型同时解决多种任务开发和应⽤。借助DeepSpeed框架实现训练过程的加速优化。同时采⽤了GPTQ和QLoRA技术对模型进⾏量化处理,旨在进⼀步提升模型的推理速度。最终,通过Vllm平台完成了模型的部署,实现了对⽂本中关键信息的⾃动化抽取,完成信息抽取的任务
联合任务数据预处理适配模型训练的解决⽅案| 实现ChatGLM-6B+LoRA训练的解决⽅案| 实现ChatGLM-6B+P-Tuning训练的解决| ⽅案基于Flask框架实现模型API接⼝开发的解决⽅案| ⼤模型并⾏计算解决⽅案| ⼤模型量化解决⽅案| ⼤模型部署解决⽅案| ⼤模型推理优化解决⽅案
理解信息抽取任务以及⽂本分类的业务意义及应⽤场景| 数据预处理:修改数据格式适配⼤模型训练、数据张量的转换等Qwen/DeepSeek模型解析| LoRA⽅法讲解| P-Tuning⽅法解析| 基于Qwen/DeepSeek+LoRA⽅法实现模型的训练和评估| 基于Qwen/DeepSeek+P-Tuning⽅法实现模型的训练和评估| 基于Flask框架开发API接⼝,实现模型线上应⽤| 数据集处理、模型构建、模型训练、模型预测| ⼤模型并⾏计算:deepspeed,数据并⾏、流⽔线并⾏、模型并⾏| ⼤模型量化:训练量化⽅法QLora,训练后量化⽅法GPTQ| 模型部署和推理优化框架:vLLM和oLLAMA
课时:8天学习方式:线下面授
基于亚⻢逊电商商品聚合⼤模型项⽬
⿊⻢直聘⼤模型搜索推荐项⽬
项⽬以“电商商品聚合与⽐价”为核⼼业务场景,解决电商场景中多源、异构商品数据的标准化处理、⾼精度分类与智能聚合难题
环境与⼯程搭建能⼒:熟练搭建Linux开发环境,吃透模型微调完整流程,精通PyTorch 与HuggingFace⽣态,具备⼯业级算法项⽬搭建基础能⼒ | 电商数据处理能⼒:掌握电商商品数据集制作、⼤模型少样本预标注、主动学习降本、难负样本挖掘,独⽴完成业务数据清洗与优化 | 多模态模型微调能⼒:精通商品分类、向量召回、同款聚合聚类三⼤任务,熟练运⽤对⽐学习、度量学习、LoRA⾼效微调,可独⽴微调图⽂多模态模型 | 主流算法与⼯具实战能⼒:掌握双塔/交叉编码器架构、FAISS向量检索、⾃动超参调优,能⽤LlamaFactory实战微调视觉⼤模型,⾃定义训练逻辑与评估指标 | 模型推理部署落地能⼒:掌握模型量化、推理加速、注意⼒优化,可快速搭建交互式演示项⽬,完成多模态⼤模型从训练、调优到线上部署全流程落地
低成本⾼质量数据集构建解决⽅案 | 使⽤Optuna进⾏⾃动超参数寻优解决⽅案 | 多模态⼤模型微调解决⽅案 | 多模态⼤模型推理部署解决⽅案 | 多模态⼤模型推理优化解决⽅案
数据为中⼼的机器学习,包括基于Krippendorff's alpha的标注质量检测、主动学习和使⽤(推理)⼤模型的Incontext Learning(zero-shot/few-shot Learing)进⾏数据与标注,解决被学术界忽略但⼯业落地最棘⼿的数据问题 | Huggingface⽣态的深⼊学习,包括⾃定义Dataset/DataCollator、Metric | ⾃定义PretrainedConfig和PreTrainedModel | ⾃定义Trainer来实现复杂的指标计算 | 深⼊介绍checkpoint保存机制 | 使⽤Optuna来进⾏超参数搜索,⽐常⽤的GridSearch更快,⽐RandomSearch更好,同时深⼊探讨⼿动模型调参和主动调参的适⽤场景 | 介绍双塔召回模型+交叉精排模型的⼯业级架构,解决两两对⽐复杂度O(n^2)计算爆炸的问题 | 详细介绍度量学习和对⽐学习,包括arcface和InfoNCE-等损失函数以及CLIP和SigLiP等多模态模型 | 同时介绍IVF和HNSW等ANN算法原理和在FAISS的⽤法使⽤多种⽅法实现多模态的融合 | 并且介绍召回模型微调的实⽤技巧:难负样本挖掘、数据对称性处理 | 介绍多模态⼤模型微调的显存优化技巧,详细介绍LoRA,包括RS-LoRA、 AdaLoRA、pissa_init和DoRA等改进 | 同时介绍GaLore和BAdam等内存⾼效的全参数微调算法以及梯度累积、FlashAttention、混合精度训练和8-bit/4-bit 量化优化器等节省显存的训练技巧 | 深⼊介绍LlamaFactory,修改其代码来实现⾃定义评估指标的计算 | 详细介绍使⽤LlamaFactory微调Qwen3 VL的优化过程 | 使⽤Gradio来展示召回与grouping模型,使⽤vLLM实现⼤模型推理 | 并且介绍常⻅部署的优化技巧,包括KV Cache和PagedAttention、GPTQ和AWQ等⼤模型量化算法、 MQA/GQA/MLA等注意⼒机制优化和推测性解码
基于⼈⼒资源招聘⾏业垂直⼤模型与知识图谱融合检索解决⽅案,通过项⽬学习完成企业级招聘检索系统全流程开发、部署、测试与优化。从Transformer底层原理、⼤模型 SFT+DPO双阶段微调、LangGraph智能体构建、招聘职位实体要素抽取及图谱关系构建,结合实时数据⼯程组件写⼊职位实体到检索引擎,完成招聘AI检索系统构建
招聘领域⼤模型微调能⼒ | ⼤模型服务化部署能⼒ | LangGraph 智能体开发能⼒ | 招聘知识图谱构建能⼒ | 搜索意图识别匹配能⼒ | Kafka+Flink实时数据流处理能⼒ | 基于Kafka消息队列实现业务解耦能⼒ | 搜索推荐(Sug)构建能⼒:基于实体图谱的搜索词补全
招聘领域⼤模型 SFT+DPO 双阶段微调解决⽅案 | 基于 LangGraph 的招聘智能体与知识图谱构建解决⽅案 | 招聘搜索意图识别与实体抽取解决⽅案 | ⼤模型 vLLM ⾼性能推理部署解决⽅案 | ElasticSearch +Redis ⾼并发职位检索解决⽅案 | 基于实体图谱的搜索词推荐(Sug)解决⽅案 | ⼤模型训练显存优化(ZeRO / 梯度检查)解决⽅案 | 招聘检索 badcase 治理与相关性优化解决⽅案
招聘领域⼤模型微调:LoRA/QLoRA微调;SFT监督微调;DPO强化学习对⻬;训练数据清洗、去重、隐私处理;微调显存优化(ZeRO、梯度检查) | ⼤模型服务化部署:vLLM/SGLang推理加速框架;KV Cache缓存机制;模型量化(FP16/INT4);⼤模型服务监控、压测与⾼并发优化 | LangGraph智能体开发:State/Node/Edge 核⼼组件;线性/条件/循环⼯作流构建;⼯具调⽤(Tool Call);招聘职位实体要素抽取及职位实体图谱构建智能体 | 招聘知识图谱构建:职位实体(岗位、结算⽅式、⼯作类型、⼯作时间等)抽取;实体关系泛化与图谱建模;职位要素分类与意图图谱构建;缓存与ES联动更新 | 搜索意图识别:⽤户搜索词意图分类;多意图表达识别;⻓尾搜索词优化;意图与职位要素匹配策略 | 检索系统核⼼技术:Kafka实时数据流处理;近实时职位⼊库与ES检索 | 搜索推荐(Sug):ES Completion Suggester原理;FST数据结构;前端防抖与实时推荐;基于实体图谱的搜索词补全 | 企业级⼯程实践:模块化设计与代码复⽤;配置与环境管理;⽇志与错误处理;分布式部署、负载均衡;Docker/K8s部署思路 | 项⽬优化与评估:检索badcase优化;意图识别准确率提升;⻓尾问题处理;模型与检索效果评测指标 | 就业导向能⼒:⼤模型⾯试考点(Transformer/微调/部署/图谱);业务场景拆解与⽅案设计
课时:0天 技术点:80项 测验:0次 学习方式:录播
学员能够掌握CNN、ResNet、Yolo及分割算法的核⼼原理| 具备开发图像分类与⽬标检测应⽤的能⼒
1. 计算机视觉背景该部分主要学习计算机视觉背景、任务、发展历史介绍,包含以下技术点:
计算机视觉定义| 计算机视觉的任务| 计算机视觉的应⽤领域| 计算机视觉的发展历史
2. 图像分析特性该部分主要学习图像特性分析与图像处理实践,包含以下技术点:
图像的表示⽅法| 图像的IO操作| 图像的颜⾊空间| 图像的加法| 图像混合| 图像的⼏何变换| 图像噪声| 图像平滑⽅法
3. 图像分类该部分主要学习图像分类与图像增强技术实践,包含以下技术点:
图像分类任务详解| 图像分类的数据集| 图像分类的评估⽅法| 常⽤的图像增强⽅法| tf.image进⾏图像增强| imagedatagenrator进⾏图像增强| 模型微调| 数据集获取| 【案例】图像⼏何颜⾊增强实践| 图像分类的CNN⽹络回顾| AlexNet⽹络实践| VGG⽹络架构| GoogLeNet详解与实践| Inception系列⽹络| ResNet⽹络结构与实践| 残差块和瓶颈块| 【案例】鲜花分类案例
4. 图像分割该部分主要学习图像分割核心知识,包含以下技术点:
图像分割定义| 图像分割的类型| 图像分割的开源数据集| 图像分割的评估指标| unet⽹络结构| 语义分割VOC数据集获取| 数据集⽣成器| 模型构建| 编码器实践| 解码器实践| 模型训练| 模型预测| 【案例】基于Unet的VOC数据的语义分割案例| 图像实例分割| MaskRCNN的⽹络构成| MaskRCNN的流程| ROIAlign原理与实践| ⽓球分割数据集的获取| 模型训练| 损失函数的实践| 模型预测| 【案例】MaskRCNN⽓球实例分割实践
课时:0天技术点:70项测验:0次学习方式:录播
能够掌握CLIP与Diffusion的核⼼原理| 独⽴搭建Stable Diffusion⽂⽣图项⽬| 熟练运⽤LoRA、ControlNet等控制技术| 能够基于Qwen系列模型完成图⽂理解任务,并利⽤ms-SWIFT或LlamaFactory框架进⾏⾼效微调,实现从模型训练到部署的完整项⽬落地
项目基于Stable Diffusion,利用稳定扩散过程,通过逐渐模糊和清晰化图像来实现图像生成的过程。这种方法在图像生成领域具有广泛的应用,项目可扩展于艺术创作、虚拟场景生成、数据增强等。
图像生成的常见解决方案| 文图匹配的解决方案| 扩散模型噪声去除的解决方案| 潜在空间扩散模型的解决方案| 扩散模型训练的解决方案| 小程序搭建的解决方案
AIGC的详解:AIGC简介,类型,应用场景,产品形态| 图像生成算法:GAN,VAE,Diffusion,DALLe,imagen| StableDiffusion的详解:Diffusion,latent diffusion;satble diffusion| stablediffusion实践:模型构建,模型训练,lora,dreambooth,图像生成效果| 图像生成小程序搭建:基于stablediffusion构建图像生成的小程序
课程名称:主要针对:主要使用开发工具:
课程名称
AI大模型开发就业班
课程推出时间
2025.04.25
课程版本号
6.5
主要使用开发工具
Python、Sklearn、Pytorch、Tensorflow、TensorBoard、HuggingFace、ModelScope、LangChain、LlamaFactory、通义百炼/PAI平台、deepseek等
课程介绍
人工智能开发V6.5课程体系升级,紧跟大模型时代热点,以企业需求为导向,专为培养和打造高级AI大模型应用与开发工程师;通过高含金量课程重磅推出,以业务为核心驱动项目开发。学生在掌握机器学习和深度学习基础上,能够解决企业级数据挖掘、NLP自然语言处理、大模型开发实际问题,通过理论和真实项目相结合,让学生能够掌握AI大模型开发核心技术和应用场景。并推出「六项目制」项目教学,通过六个不同类型和开发深度的项目,使学员能够全面面对大部分企业人工智能应用场景。
构建大型项目库,多行业多领域人工智能项目课程,主流行业全覆盖,其中项目课程包括了多行业10个场景的项目课程,让学生达到大厂的项目经验要求。
课程消化吸收方面:V6.5在V5.0版本基础上迭代更新,加大了大模型开发比例,同时注重专业课的消化吸收,降低学习难度,提升就业质量。
全新升级四大课程优势,助力IT职业教育行业变革:
优势1:热门岗位全覆盖,匹配企业岗位需求,拓宽职业选择,实现阶段目标;优势2:与大厂合作,共建大模型课程,助力掌握前沿技术,增强就业竞争力;优势3:定制垂直领域大模型,专项领域赋能,打造就业薪资高,就业速度快的AI大模型人才;优势4:大模型模块开发完整图谱,课程涵盖大模型提示词工程、RAG、Agent智能体、大模型微调与蒸馏全栈大模型核心技术。
1
新增大模型RAG系统开发的基于职业教育领域的EduRAG大模型项目,覆盖企业构建RAG所有优化场景
1
新增大模型Coze低代码平台构建Agent与RAG,完成企业快速搭建智能体需求
1
新增大模型Dify+RagFlow灵活构建定制化的Agent与知识库,完成企业各种多样化智能体搭建需求
1
新增大模型蒸馏理论基础与实战项目,以企业实际需求为导向讲授大模型蒸馏的细节
1
新增DeepSeek大模型原理、优化、微调、部署及智能体应用,全方面融入DeepSeek
1
新增企业级大模型平台项目,增加讯飞星火Maas平台、阿里PAI平台、百炼平台,快速搭建大模型应用
1
新增LlamaFactory大模型框架,可通过命令快速搭建大模型微调、蒸馏等应用场景
1
新增知识图谱项目新增KBQA智能问答模块,扩展知识图谱使用场景
1
新增基于Qwen/DeepSeek通义大模型的头条新闻分类项目,融入vllm、Deepseed等大模型部署和加速框架
1
优化部分底座大模型,更新为了行业领先大模型,比如QWen、DeepSeek
1
优化机器学习不常用数据挖掘算法,诸如SVM和朴素贝叶斯
1
优化知识图谱中项目架构,优化了NER、关系抽取的核心模型
1
优化基于Streamlit+LangChain搭建智能聊天机器人
1
优化大模型阶段优化为大模型微调、大模型智能体、大模型RAG、大模型前沿技术专题模块
1
新增就业实战冲刺阶段面试核心技能梳理升级,增加大模型核心面试题
1
友情提示更多学习视频+资料+源码,请在线咨询。
课程名称
人工智能AI进阶班/AI大模型开发
课程推出时间
2024.06.06
课程版本号
5.0
主要使用开发工具
PyCharm、DataGrip、Jupyter NoteBook
课程介绍
人工智能开发V5.0课程体系升级以企业需求为导向,专为培养和打造高级人工智能工程师、高含金量课程重磅推出,以业务为核心驱动项目开发,课程包括机器学习和深度学习框架Scikit-Learn和Pytorch,能够解决企业级数据挖掘、NLP自然语言处理、大模型开发与CV计算机视觉实际问题,通过理论和真实项目相结合,让学生能够掌握人工智能核心技术和应用场景。并推出「六项目制」项目教学,通过六个不同类型和开发深度的项目,使学员能够全面面对大部分企业人工智能应用场景。大型项目库,多行业多领域人工智能项目课程,主流行业全覆盖,其中项目课程包括了多行业13个场景的项目课程,让学生达到大厂的项目经验要求。课程消化吸收方面:V5.0在V4.0版本基础上迭代更新,加大了大模型开发比例,同时注重专业课的消化吸收,降低学习难度,提升就业质量。
全新升级四大课程优势,助力IT职业教育行业变革:
优势1:热门岗位全覆盖,匹配企业岗位需求,拓宽职业选择,实现阶段目标;优势2:与大厂合作,共建大模型课程,助力掌握前沿技术,增强就业竞争力;优势3:定制垂直领域大模型,专项领域赋能,打造就业薪资高,就业速度快的AI大模型人才;优势4:覆盖NLP,CV完整解决方案和技术栈,解决多业务场景问题。
1
更新Pytorch2.3.0
1
新增星火语音大模型
1
新增基于讯飞大模型定制平台的财经新闻情感分析项目
1
新增多风格英译汉翻译机项目
1
新增虚拟试衣项目
1
新增基于StableDiffusion的图像生成项目
1
新增大模型AI Agent开发应用
1
新增新零售行业评价决策系统
1
新增大模型搭建医疗问诊机器人
1
新增物流信息咨询智能问答项目
1
新增微博文本信息抽取项目
1
新增泛娱数据关系抽取项目
1
新增多模态技术及项目
1
友情提示更多学习视频+资料+源码,请加QQ:2632311208。
课程名称
人工智能AI进阶班
课程推出时间
2023.02.24
课程版本号
4.0
主要使用开发工具
Linux+PyCharm+Scikit-Learn+Pytorch+Neo4j+Docker
主要培养目标
以数据挖掘和NLP自然语言处理为核心方向,培养企业应用型高精尖AI人才
课程介绍
人工智能开发V4.0课程体系升级以企业需求为导向,专为培养和打造高级人工智能工程师、高含金量课程重磅推出,以业务为核心驱动项目开发,课程包括机器学习和深度学习框架Scikit-Learn和Pytorch,能够解决企业级数据挖掘、NLP自然语言处理与CV计算机视觉实际问题,通过理论和真实项目相结合,让学生能够掌握人工智能核心技术和应用场景。并推出「六项目制」项目教学,通过六个不同类型和开发深度的项目,使学员能够全面面对大部分企业人工智能应用场景。大型项目库,多行业多领域人工智能项目课程,主流行业全覆盖,其中项目课程包括了多行业13个场景的项目课程,让学生达到大厂的项目经验要求。课程消化吸收方面:V4.0在V3.0版本基础上迭代更新,注重专业课的消化吸收,降低学习难度,提升就业质量。
1
优化Python系统编程,针对人工智能必须的Python高阶知识体系重构课程,增加基础数据结构内容
1
新增机器学习部分[数据挖掘项目实战],以多场景业务为背景,通过SQL和Pandas完成数据处理与统计分析,夯实使用机器学习解决数据挖掘问题能力。
1
新增NLP方向[知识图谱项目],基于知识图谱的多功能问答机器人项目, 主要解决当前NLP领域中大规模知识图谱构建的问题和图谱落地的问题.知识图谱的构建主要分为知识构建和知识存储两大子系统. 包括知识构建, 知识存储, 知识表达, 路由分发, 结果融合等实现.最终呈现一个基于知识图谱的问答机器人。
新增[知识抽取项目],该项目针对于泛娱乐场景下复杂业务关系进行实体抽取,帮助企业构建知识图谱。
1
优化NLP方向[NLP基础课程]:修改文本数据增强方法,解决原始谷歌接口被限制调用的问题;优化Seq2Seq英译法案例,修改原始代码bug,提升模型的准确率;新增FastText模型架构介绍;加深FastText模型处理分类的问题的原理理解;新增Word2Vec训练两种优化策略,加速模型快速收敛。
1
优化计算机视觉CV基础:图像分类的经典网络,开山之作ALexNet,VGGNet,GoogLenNet,ResNeT,ResNetV2,VGGRep,SeNet,轻量型网络:mobileNet,shuffleNet,EfficientNet,模型微调,数据增强,cutmix,copypaste,mosaic,目标检测任务,IOU,Map,正负样本设计,smoothL1损失,RCNN系列网络架构:RCNN,FastRCNN,FasterRCNN,MaskRCNN,FPN结构,ROIpooling设计,anchor思想,RoiAlign设计,训练策略;yolo系列网络V1-V8:DarkNet,yolo-FPN特征融合,passthrough融合方法,多尺度训练,IOU系列损失,DIOU,CIOU,SIOU等,输出端的解耦,REP-PAN结构,E-ELAN结构,预测阶段的BN设计,SPP和SPPF结构
1
优化智慧交通项目:目标跟踪方法,运动模型的设计,DBT和DFT初始化方法,JIT的加速方法,yoloV7目标检测,REP的使用,检测辅助端的使用,E-ELAN的使用,backbone的实现,head结构的实现,数据分析,数据预处理,数据增强,模型训练,预测与评估,车辆检测,kalman的使用,预测和更新阶段,KM算法的匹配,匈牙利算法,IOU匹配,级联匹配,ReId特征提取,欧式距离,余弦距离,马氏距离计算,目标状态更新,Deepsort算法目标跟踪,代价矩阵的设计,虚拟线圈的设计,线圈位置的获取,双线圈检测车流量支持mac电脑的m1芯片和m2芯片的学习
课程名称
人工智能AI进阶班
课程推出时间
2022.01.20
课程版本号
3.0
主要培养目标
以机器学习和深度学习技术,培养企业应用型高精尖AI人才
主要使用开发工具
Linux+PyCharm+DataSpell+Pytorch+Tensorflow+Neo4j+Docer+k8s
课程介绍
人工智能V3.0课程体系升级以企业需求为导向,专为培养和打造高级人工智能工程师、高含金量课程重磅推出,以业务为核心驱动项目开发,课程包括机器学习和深度学习框架Pytorch和TensorFlow,能够解决企业级数据挖掘、NLP自然语言处理与CV计算机视觉实际问题,通过理论和真实项目相结合,让学生能够掌握人工智能核心技术和应用场景。并推出「六项目制」项目教学,通过六个不同类型和开发深度的项目,使学员能够全面面对大部分企业人工智能应用场景。大型项目库,多行业多领域人工智能项目课程,主流行业全覆盖,其中项目课程天数占比为100天,包括了多行业13个场景的项目课程,让学生达到大厂的项目经验要求。课程消化吸收方面:V3.0在V2.0版本基础上迭代更新,注重专业课的消化吸收,降低学习难度,提升就业质量。
1
优化优化Python系统编程,针对人工智能必须的Python高阶知识体系重构课程
1
新增[数据处理与统计分析阶段],以Linux为基础,通过SQL和Pandas完成数据处理与统计分析,为人工智能数据处理奠定技术基础。
1
优化优化机器学习算法,每个算法都兼具使用场景,数学推导过程及参数调优
1
新增[机器学习与多场景],增加多场景案例实战,包括用户画像,电商运营建模等多场景案例实战
1
新增数据挖掘方向[百京金融风控]项目,从反欺诈、信用风险策略、评分卡模型构建等热点知识,使得学员具备中高级金融风控分析师能力。
1
新增数据挖掘方向[万米推荐系统]项目,从多数据源采集、多路召回、基于机器学习算法粗排算法与基于深度学习精排,解决了在大数据场景下如何实现完整推荐系统,使得学员可以具备企业级推荐项目开发能力。
1
优化深度学习基础课由TensorFlow切换为Pytorch,面向零基础同学更加友好
1
优化NLP基础课程Transform基础和Attention注意力机制在原理之后增加英译汉的案例,加强学生对基础算法原理的理解
1
优化NLP基础课程迁移学习API版本变化问题,优化传统序列模型算法原理
1
新增NLP方向[蜂窝头条文本分类优化]项目,增强学生NLP算法优化方面技能
1
新增NLP方向[知识图谱]项目,通过本体建模,知识抽取,知识融合,知识推理,知识存储与知识应用方面,学生可以掌握完整知识图谱构建流程。
1
新增[面试加强课]通过巩固机器学习与深度学习基础算法,加强核心算法掌握,增加数据结构基础算法、动态规划算法、贪心算法等面试高频算法题,加强多行业人工智能案例理解与剖析
1
删除Ubuntu环境搭建开发环境
课程名称
人工智能AI进阶班
课程推出时间
2021.02.01
课程版本号
2.0
主要针对
python3 & python2
主要使用开发工具
linux+PyCharm+Pytorch+Tensorflow+OpenCV+neo4j+Docer+k8s
课程介绍
AI理论方面: 通过新的开发的文本摘要项目、传智大脑项目, 提升学员复杂模型训练和优化的能力。
AI工程化方面: 新增的算法工程化讲座, 直接面向一线公司实际开发场景和需求, 比如服务日志, A/B测试, Git提交, Docker, K8S部署等, 让学员亲临公司场景, 求职后更好的无缝衔接进企业级开发。
AI新热点和趋势: 通过增加量化、剪枝、知识蒸馏、迁移学习等一线优化技术, 让学生有更多处理问题的武器和思路;增加知识图谱热点、mmlab框架热点、YOLO1~5算法系列,能更好的匹配业界需求。
课程消化吸收方面:V2.0在V.1.x版本基础上迭代更新,注重专业课的消化吸收,降低学习难度,提升就业速度、就业质量。
1
新增NLP方向【文本摘要项目】:自动完成文本信息的主题提取,中心思想提取,可以类比京东,当当网的商品自动宣传文案;快速的将主要信息展示给用户, 广泛应用于财经, 体育, 电商, 医疗, 法律等领域。基于seq2seq + attention的优化模型,基于PGN + attention + coverage的优化模型,基于PGN + beam-search的优化模型,文本的ROUGE评估方案和代码实现:weight-tying的优化策略、scheduled sampling的优化策略。
1
新增AI基础设置类项目【传智大脑】,目前提供AI前端功能展示、AI后端模型部署、AI在线服务、AI模型训练功能等系统功能。AI开发服务提供了信息中心网咨辅助系统,文本分类系统、考试中心试卷自动批阅系统、CV统计全国开班人数等系统;综合NLP、CV和未来技术热点。
1
新增CV方向【人流量统计项目】:以特定商场、客服场景对人流量进行分析和统计。掌握mmlab框架、核心模块MMDetection;resnet骨架网络特征提取,SSD网络和Cascade R-CNN网络目标检测;利用剪枝,压缩和蒸馏等方法减小模型规模;完成前后端部署(Flask + Gunicorn)、模型部署(ONNX-runtime技术)。
1
优化NLP方向【AI在线医生项目】: 两个离线模型 (命名实体审核模型, 命名实体识别模型)的优化,提升准确率, 召回率,F1的效果。 一个在线模型 (句子主题相关模型)的优化, 重在量化, 压缩, 知识蒸馏, 提升处理速度并展示对比测试实验。
1
新增知识图谱热点案例:知识图谱编程、深化neo4j中的cypher代码, 相关案例。
1
新增计算机视觉目标检测热点算法YoLov1~v5 V1~V5模型的网络架构、输入输出、训练样本构建,损失函数设计;模型间的改进方法;多尺度检测方法、先验框设计;数据增强方法、多种网络架构及设计不同模型的方法。
1
优化计算机视觉专业课:RCNN系列网络进阶课程:FasterRCNN目标检测的思想,anchor(锚框)设计与实现,掌握RPN网络是如何进行候选区域的生成的,掌握ROIPooling的使用方法掌握fasterRCNN的训练方法,掌握RCNN网络的预测方法。
1
新增AI算法工程化专题:10个子案例展示算法工程化中的实际工程问题, 企业真实开发中的问题和解决方案。研发, 测试环境的异同, 服务日志的介绍和实现, A/B测试,模型服务风险监控,在线服务重要指标,Git提交与代码规范化,正式环境部署(Docker, K8S),,数据分析与反馈。
课程名称
人工智能AI进阶班
课程推出时间
2020.6.1
课程版本号
1.5
主要针对版本
python3 & python2
主要使用开发工具
linux+PyCharm+Pytorch+Tensorflow
课程介绍
以周为单位迭代更新课程,包括机器学习、自然语言处理NLP、计算机视觉、AI算法强化等课程。同时为了更好的满足人工智能学员更快速的适应市场要求,推出了自然语言处理NLP案例库、计算机视觉CV案例库、面试强化题等等。同时也增加职业拓展课,学生学习完AI课程以后,可在职学习:推荐系统、爬虫、泛人工智能数据分析。
1
新增计算机视觉CV案例库
1
新增自然语言处理案例库
1
新增AI企业面试题
1
新增算法强化课程
1
新增计算机视觉强化课
课程名称
人工智能AI进阶班
课程推出时间
2019.12.21
课程版本号
1.0
主要针对版本
Python3 & Python2
主要使用开发工具
linux+PyCharm+Pytorch+Tensorflow
课程介绍
人工智能赋能实体产业的规模以每年40%的速度递增,人工智能人才在计算机视觉CV、自然语言处理NLP、数据科学的推荐广告搜索的需求越来越明确。传智教育研究院经过2年潜心研发,萃取百余位同行经验,推出全新的人工智能1.0课程。全新的人工智能课程体系具有以下优势:
1)六个月高级软件工程师培训课程。精准定位、因材施教,人工智能和Python开发分成两个不同的班型进行授课。
2)理论+实践培养AI专精型人才。如何培养人才达到企业的用人标准?传智教育提出了课程研发标准:1、AI理论方面,培养学员AI算法研究能力:AI算法实用性、先进性、可拓展性;2、AI实践方面,培养学员利用AI理论解决企业业务流的能力。
3)多领域多行业项目,全生态任性就业。设计多领域多行业项目有:智能交通项目(CV)、 实时人脸检测项目(CV)、在线AI医生项目(NLP)、智能文本分类项目(NLP)、泛娱乐推荐项目(CV+推荐)、CT图像肺结节自动检测项目(CV)、小智同学-聊天机器人(NLP)、场景识别项目(CV)、在线图片识别-商品检测项目(CV)、黑马头条推荐系统(推荐+数据科学)。
4)AI职业全技能(NLP、CV、数据科学-推荐广告搜索),涵盖8大主流就业岗位。视觉处理工程师(CV)、自然语言处理工程师(NLP)、推荐系统工程师、机器学习工程师、深度学习工程师、数据分析工程师、数据挖掘工程师、知识图谱工程师。
5)课程设置科学合理,适合AI技术初学者。
6)技术大牛倾力研发,专职沉淀AI新技术。
1
新增机器学习进阶课程
1
新增计算机视觉项目:实时人脸检测项目、智能交通项目
1
新增自然语言处理NLP项目:在线AI医生项目、智能文本分类项目
1
新增算法强化课程:进化学习、分布式机器学习、数据结构强化
教师录取率<3%,从源头把控师资,带你过关斩将掌握每一个知识点
用数据驱动教学,贯通教/学/练/测/评,为每一位学员私人定制学习计划和就业服务


学前入学多维测评
学前目标导向式学习
学中随堂诊断纠错
学中阶段效果测评
学后在线作业试题库
学后问答社区查漏补缺
保障BI报表数据呈现
就业面试指导就业分析
就业流程
全信息化处理
学员能力
雷达图分析
定制个性化
就业服务
技术面试题
讲解
就业指导课
面试项目分析
HR面试攻略
模拟企业
真实面试
专业简历指导
面试复盘辅导
风险预警
企业黑名单提醒
老学员毕业后即可加入传智汇精英社区,持续助力学员职场发展

传智教育旗下IT互联网精英社区,以汇聚互联网前沿技术为核心,以传递、分享为己任,联合经纬创投、创新工场、京东人工智能、华为等众多关注互联网的知名机构及企业、行业大咖,共同研究中国互联网深度融合、跨界渗透、整合汇聚、相互促进的信息化资源共享平台。
行业沙龙

高端人脉

职场资源

技术研习

9970元/月平均薪资
15900元/月最高薪资
100%就业率
58人月薪过万
*学员就业信息统计数据为数据库中实时调取的真实相关数据,非广告宣传
江苏传智播客教育科技股份有限公司 版权所有Copyright 2006-2026, All Rights Reserved 苏ICP备16007882号 营业执照 增值电信业务经营许可证 出版物经营许可证  苏公网安备 32132202000574号